भाषा से गति तक
शब्दों और सांकेतिक भाषा के बीच की दूरी का अध्ययन।
एक कैप्चर स्टूडियो, और वे मापक उपकरण जो उसे ईमानदार रखते हैं।
इस साइट के लिए Blender में बनाया गया एक चित्रण। यह विचार को समझाता है; यह परियोजना का डेटा नहीं है।
परियोजनाओं की मूल तस्वीरें, आरेख और वीडियो उनकी मूल भाषा में दिखाए गए हैं।
विज्ञान शिक्षा को अधिक सुलभ बनाने की कोशिश मुझे एक कठिन शोध प्रश्न तक ले गई: भाषा को समन्वित गति से कैसे जोड़ा जा सकता है? Sign-Translator स्टूडियो वीडियो से लेकर रेंडर किए गए अवतार तक इस प्रश्न की पड़ताल करता है, और उत्पन्न गति को भाषाई रूप से प्रमाणित अमेरिकी सांकेतिक भाषा (ASL) से अलग रखता है। अब तक किसी बधिर सांकेतिक भाषा उपयोगकर्ता ने इसके आउटपुट का मूल्यांकन नहीं किया है, और जहाँ भी कोई परिणाम दिखता है, परियोजना यह बात साफ़ कहती है।
हस्त मुद्राओं के एक क्रम से भी अधिक
सांकेतिक भाषा में हाथ, शरीर, चेहरा, नज़र और समय-निर्धारण का तालमेल होता है। परियोजना इन सबको एक ही घड़ी पर दर्शाती है: 24 फ़्रेम प्रति सेकंड पर ग्यारह चैनल, जिनमें शरीर और हाथ के रोटेशन, सिर की गति, चेहरे के 52 गुणांक, नज़र, पलक झपकना और संपर्क शामिल हैं। हर मान के साथ यह चिह्न होता है कि उसे वास्तव में देखा गया था या नहीं, ताकि अनुपलब्ध डेटा चुपचाप भर दिए जाने के बजाय दिखता रहे।
दो कैमरे, एक कंकाल
गति स्टूडियो वीडियो से आती है, जिसे सामने और बगल से फ़िल्माया गया है। एक पोज़ एस्टिमेटर हर दृश्य में कीपॉइंट ढूँढता है; दृश्यों को कलाइयों और कोहनियों की गति से सिंक्रनाइज़ किया जाता है, कैमरों का कैलिब्रेशन फ़ुटेज से ही होता है, और मेल खाते बिंदुओं का ट्राइएंगुलेशन करके उन्हें 3D में बदला जाता है। इस चरण की एक खोज: जब दोनों कैमरे सांकेतिक भाषा उपयोगकर्ता पर स्थिर हों, तो केवल ज्यामिति से फ़ोकल लंबाई नहीं निकाली जा सकती। कैलिब्रेशन में कठोर-हड्डी-लंबाई (rigid-bone-length) का पद जोड़ने से फ़ोकल त्रुटि 40–47% से घटकर 1% के भीतर आ गई।
गति की एक शब्दावली
एक रेज़िडुअल वेक्टर क्वांटाइज़र हर फ़्रेम को 32 असतत (discrete) कोड में बदलता है: चार शारीरिक हिस्से (शरीर, बायाँ हाथ, दायाँ हाथ, चेहरा), जिनमें से हर एक को आठ चरणों में परिष्कृत किया जाता है। हिस्सों के हिसाब से बाँटने से वे भेद बने रहते हैं जिन्हें निर्देशांकों की एक ही धारा धुंधला कर देती। एक कोडबुक से रेज़िडुअल डिज़ाइन पर जाने से रीकंस्ट्रक्शन त्रुटि लगभग 19° और 11 cm से घटकर लगभग 8° और 2 cm रह गई।
क्या काम नहीं किया, और उसकी जगह क्या आया
पहली योजना यह थी कि टेक्स्ट से पूरे वाक्य की गति एक ही बार में उत्पन्न की जाए। परियोजना के मापक उपकरणों पर कोई भी एंड-टू-एंड जनरेटर ख़ाली गति से अलग नहीं दिखा। मौजूदा रास्ता कंपोज़िशन है: हर शब्द को अलग से उत्पन्न करना, उसे सोलह बार सैंपल करना, वह सैंपल रखना जिसे एक पहचानकर्ता (recogniser) सबसे अच्छी तरह पढ़ता है, और अनुमानित टाइमिंग से शब्दों को जोड़ना। आउटपुट अंग्रेज़ी शब्द-क्रम का पालन करता है, जो ASL का व्याकरण नहीं है, और परियोजना यह बात साफ़ कहती है।
पैमाने को पढ़ना
उत्पन्न गति को वापस अंग्रेज़ी में अनुवाद करके और स्रोत वाक्य से तुलना करके अंक दिए जाते हैं, और हमेशा नियंत्रणों के साथ: वास्तविक सांकेतिक भाषा, ख़ाली गति, उलटा-पुलटा क्रम और ग़लत वाक्य। वाक्यों के एक नए सेट पर, जिसे केवल एक बार पढ़ा गया, कंपोज़िशन को 2.40, वास्तविक सांकेतिक भाषा को 4.03 और ख़ाली गति को 2.05 अंक मिले। लक्ष्य 2.55 था। वह हासिल नहीं हुआ, और परिणाम को दोबारा कोशिश किए बिना प्रकाशित कर दिया गया।
भाषा को पूरी पाइपलाइन में जीवित रहना होगा।
- 01
गति को एक घड़ी पर रखें
How2Sign के सामने और बगल वाले वीडियो को लैंडमार्क की गति के आधार पर संरेखित किया जाता है, फिर कैमरों का कैलिब्रेशन, स्थितियों का ट्राइएंगुलेशन और जोड़ों के रोटेशन की फ़िटिंग होती है। रीप्रोजेक्शन और कठोर-हड्डी (rigid-bone) जाँचें पुनर्निर्माण को सीमित रखती हैं। ये वीडियो से निकाले गए अनुमान हैं, जिनका स्रोत-विवरण सुरक्षित रखा गया है; ये मोशन-कैप्चर जैसा ग्राउंड ट्रुथ नहीं हैं।
- 02
निर्देशांक नहीं, कोड का अनुमान
एक ऑटोरिग्रेसिव ट्रांसफ़ॉर्मर टेक्स्ट से रेज़िडुअल कोड का अनुमान लगाता है: फ़्रेमों पर एक कॉज़ल टेम्पोरल मॉडल, एक बाइट-स्तरीय टेक्स्ट एनकोडर, और आठ चरणों पर एक छोटा डेप्थ मॉडल। शुरुआती फ़्री-रनिंग सैंपल, वन-स्टेप प्रेडिक्शन से जितनी उम्मीद थी, उससे कहीं कम पहचाने गए; ट्रिमिंग, हिस्ट्री ड्रॉपआउट और मास्क्ड लॉस ने अलग-अलग शब्दों के लिए इस अंतर का अधिकांश हिस्सा पाट दिया।
- 03
परीक्षण करें कि स्कोर क्या माप रहा है
पहले के एक रिट्रीवल मूल्यांकक ने शून्य किए गए रोटेशन वाली गति को भी आश्चर्यजनक रूप से अच्छे अंक दे दिए: क्लिप की अवधि से उत्तर लीक हो रहा था। तय दो-सेकंड की विंडो, यादृच्छिक ऑफ़सेट और केवल-अवधि वाले एक नियंत्रण ने इस शॉर्टकट को परखने योग्य बनाया। जनरेटर को ग्रेड करने की अनुमति मिलने से पहले, बाद के हर मापक उपकरण पर यही संदेह लागू किया जाता है।
रिलीज़ का मानदंड किसी भी मानवीय रेटिंग से पहले तय कर दिया गया था: बधिर मूल्यांकनकर्ताओं को उत्पन्न वाक्य कम से कम 70% बार समझ आने चाहिए, और वास्तविक सांकेतिक भाषा से दस अंकों के भीतर। वह अध्ययन डिज़ाइन किया गया है, पर चलाया नहीं गया। जब तक वह नहीं होता, यहाँ कुछ भी समझ में आने योग्य ASL के दावे का समर्थन नहीं करता।
सतत-प्रशिक्षण प्रयोग पढ़ेंईमानदार सीमाएँ।
- किसी बधिर सांकेतिक भाषा उपयोगकर्ता ने उत्पन्न गति का मूल्यांकन नहीं किया है। स्वचालित स्कोर एक परोक्ष पैमाना हैं, समझ नहीं।
- आउटपुट अंग्रेज़ी शब्द-क्रम का पालन करता है और ASL व्याकरण का मॉडल नहीं बनाता।
- मॉडल वेट्स जारी नहीं किए गए हैं, और यह सिस्टम कोई तैनात अनुवादक नहीं है।
अवलोकन से गति तक।
अंग्रेजी ऑडियो। कैप्शन सभी दस साइट भाषाओं में उपलब्ध हैं; अनुवाद मशीन-सहायता प्राप्त हैं।
प्रतिलेख पढ़ें
00:00 वह सारी जिज्ञासा मुझे साइन-ट्रांसलेटर तक ले गई।
00:03 दो कैमरों की रेखाएं प्रत्येक जोड़ पर मिलती हैं, जो 3डी में इसकी स्थिति बताती है।
00:08 हड्डियों की लंबाई स्थिर रहने की शर्त से फोकल लंबाई की त्रुटि 40% से अधिक से घटकर 1% के भीतर आ गई।
00:14 फिर गति को शब्दावली जैसे कोड में संपीड़ित किया जाता है और Transformer अंग्रेज़ी से वे कोड बनाता है।
00:21 फिर लगभग सब कुछ विफल हो गया।
00:22 पूरे वाक्य की गति बनाने वाले मॉडल, स्थिर खड़े रहने की तुलना में अर्थ बेहतर नहीं पहुँचा पाए।
00:26 एक मॉडल ने गति की सभी 95 जाँचें पास कीं, फिर भी वह एक वाक्य का अर्थ नहीं पहुँचा सका।
00:32 तो अब सिस्टम प्रत्येक शब्द को अलग से उत्पन्न करता है और क्लिप को एक साथ जोड़ता है।
00:37 जिन शब्दों को वह नहीं जानता, वे बस गायब हो जाते हैं।
00:39 इसे स्कोर करने के लिए, एक मॉडल गति को वापस अंग्रेजी में पढ़ता है।
00:43 बिना गति वाले इनपुट का स्कोर 2.05, बनाई गई गति का 2.4 और वास्तविक सांकेतिक भाषा का लगभग 4 है।
00:49 सुधार छोटा है, लेकिन यह एक शुरुआत है।
00:51 देखने के लिए धन्यवाद।
प्लेबैक प्रारंभ नहीं हो सका। वीडियो नियंत्रण आज़माएँ या वीडियो डाउनलोड करें।
मेरी पोर्टफोलियो फिल्म का एक अंश: हाथ के स्थल चिन्ह, पुनर्निर्माण, उत्पन्न गति, और मूल्यांकन सीमाएँ। प्रस्तुत अवतार और स्वचालित स्कोर अनुसंधान कार्य प्रगति पर प्रदर्शित करते हैं; वे सांकेतिक भाषा की सुगमता स्थापित नहीं करते हैं।
शब्दों से
से आंदोलन।
एक पोज़ ही है
शुरुआत।
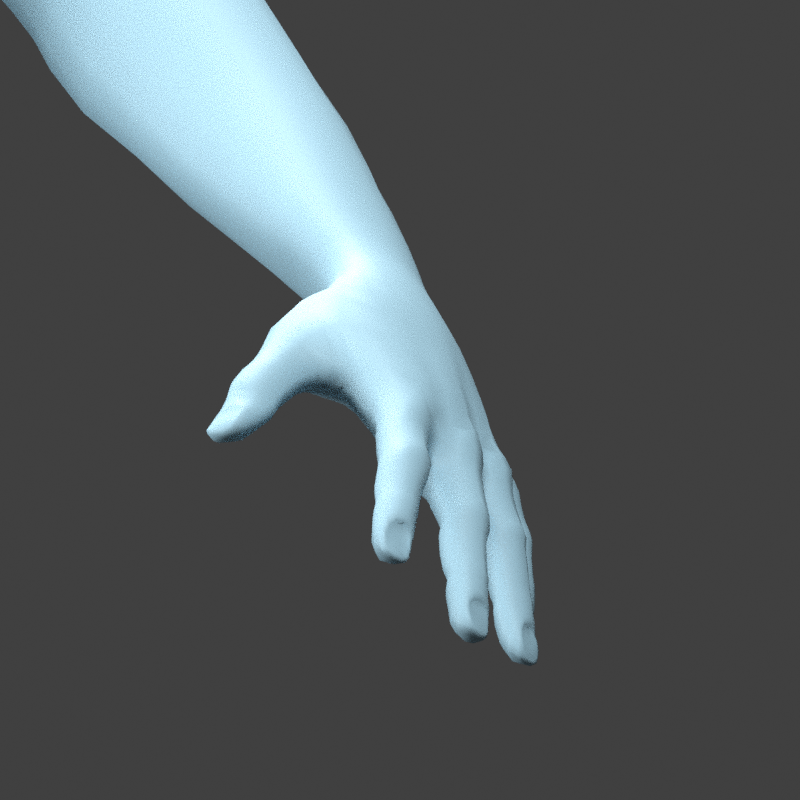
एक मोशन मॉडल को अंततः एक बॉडी को चलाना पड़ता है। यह मूल हस्त-आर्टिक्यूलेशन रेंडर रिपॉजिटरी के रिग चेक से आता है: एक अवतार के पीछे ज्यामिति और संयुक्त व्यवहार पर एक करीबी नज़र।
स्टेटिक रिग परीक्षण। इसमें अनुवादित वाक्य का चित्रण नहीं है।
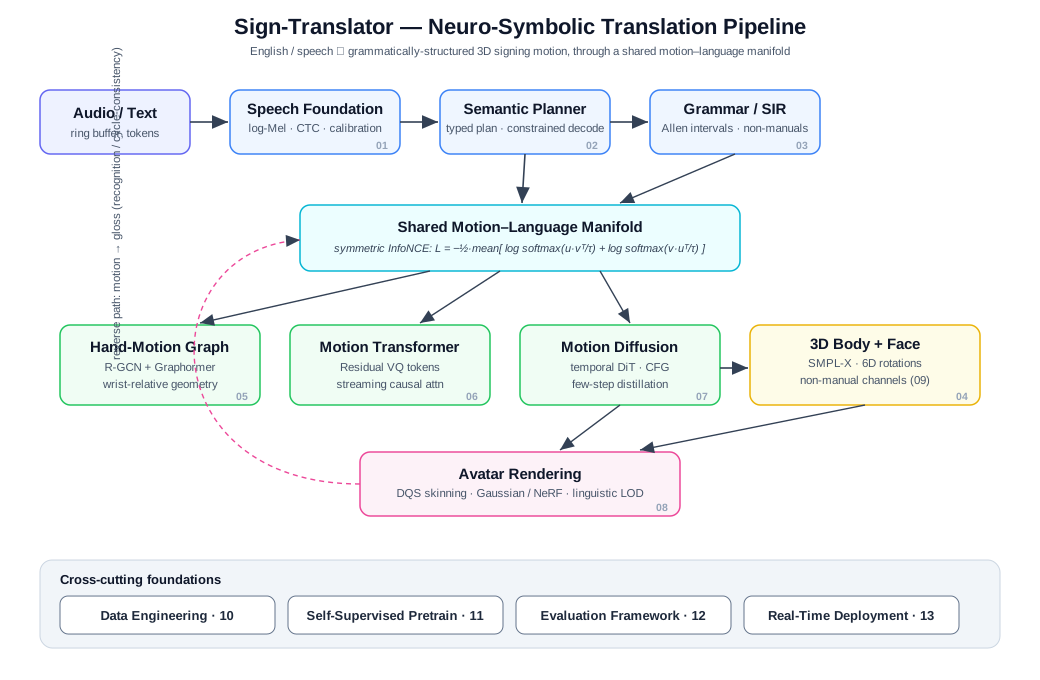
प्रणाली, और इसकी सीमाएँ।
रिपोजिटरी का आर्किटेक्चर मानचित्र चलने योग्य सिंथेटिक कोर को बड़े अनुवाद डिज़ाइन से अलग करता है। ऊपर वर्णित नए निरंतर-गति प्रयोग एक अलग प्रशिक्षण पथ का अनुसरण करते हैं।
पूर्ण आकार का आरेख देखें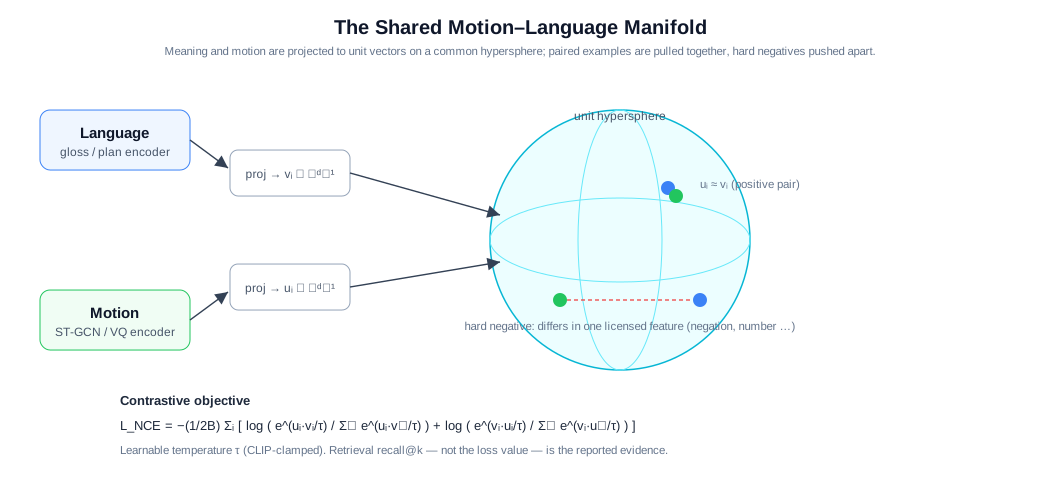
क्या भाषा और आंदोलन मिल सकते हैं?
एक स्पेटियोटेम्पोरल ग्राफ नेटवर्क संयुक्त गति को एन्कोड करता है। भाषा और गति वैक्टर को सामान्यीकृत किया जाता है और एक सममित विपरीत हानि के साथ संरेखित किया जाता है: मेल खाने वाले जोड़े बेमेल जोड़े की तुलना में करीब होने चाहिए। पुनर्प्राप्ति परीक्षण उस संरेखण की जांच करते हैं।
पूर्ण आकार का आरेख देखेंआगे की खोजसशर्त प्रसार कैसे डिज़ाइन किया गया था
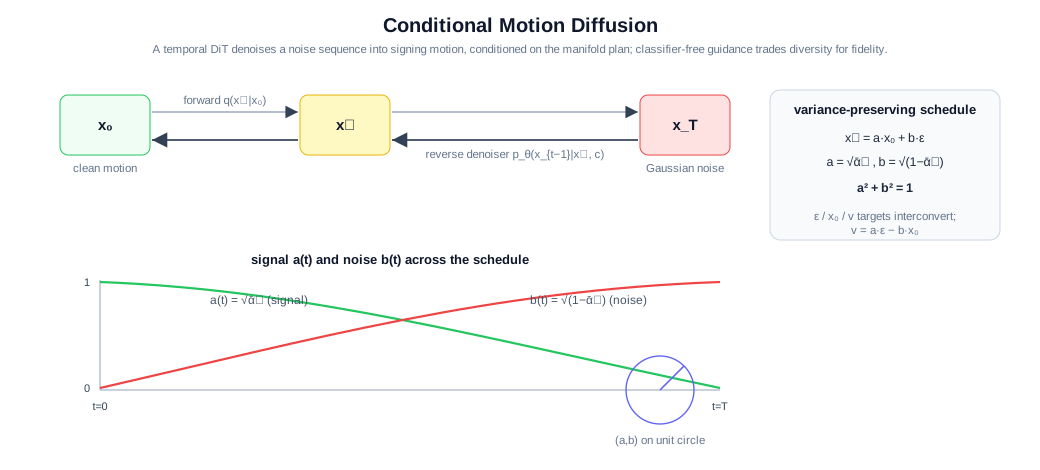
एक जनरेटिव परिकल्पना।
यह आरेख सशर्त-प्रसार अनुसंधान डिजाइन का दस्तावेजीकरण करता है। निरंतर प्रयोगों ने लगभग स्थैतिक विफलता मोड को उजागर किया; इसके बजाय चयनित सतत डिकोडर अलग गति कोड का उपयोग करता है।
पूर्ण आकार का आरेख देखेंआगे की खोजस्ट्रीमिंग मोशन के लिए क्या आवश्यक है
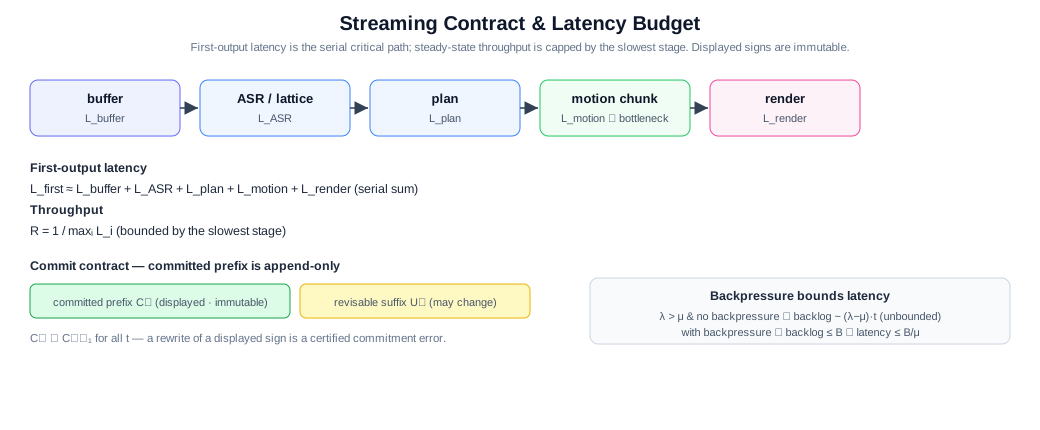
टाइमिंग इंटरफ़ेस का हिस्सा है।
स्ट्रीमिंग अनुबंध पहले आउटपुट के समय को निरंतर थ्रूपुट से अलग करता है। यह एक परिशिष्ट-केवल प्रतिबद्ध उपसर्ग को भी निर्दिष्ट करता है ताकि बाद की भविष्यवाणी पहले से दिखाए गए गति को फिर से नहीं लिख सके। यह एक डिज़ाइन अनुबंध है, न कि मापा गया उत्पादन-विलंबता दावा।
पूर्ण आकार का आरेख देखेंयह कहाँ जुड़ता है।
 दिशा की तलाशदोनों एक भौतिक ढाँचे को उसकी सीमाओं के भीतर चलाते हैं: वहाँ एक पतवार, यहाँ उँगलियों के तीस जोड़।
 एजेंट का बेहतर मूल्यांकनग्रेडरों पर वही संदेह: कुछ भी अंकित करने से पहले मापक उपकरण की जाँच।
 CollegeAdvisorदोनों ऐसा आत्मविश्वासी उत्तर देने के बजाय, जिसका साक्ष्य समर्थन न करे, उत्तर न देना बेहतर समझते हैं।
सक्रिय शोध प्रोटोटाइप। नीचे दिए आरेख शोध-डिज़ाइन के पहले के हिस्सों को दर्ज करते हैं, और हाथ की तस्वीर एक रिग परीक्षण है। न तो उत्पन्न की गई गति और न ही कोई रेंडरिंग जाँच यह स्थापित करती है कि यह भाषाई रूप से मान्य ASL है। स्वतंत्र बोधगम्यता मूल्यांकन अब भी आवश्यक है। स्टूडियो वीडियो: How2Sign (CC BY-NC 4.0)।