言葉を動きに
単語と手話との間の距離を研究する。
モーション撮影のスタジオと、その結果を正直に保つ計測手段。
このサイトのために Blender で制作したイラストです。考え方を説明するためのもので、プロジェクトのデータではありません。
プロジェクトの画像・図・動画は原文のまま掲載しています。
科学教育をもっと身近にしようとするうちに、難しい研究課題に行き着きました。言語は、協調した身体の動きとどう結びつくのか。Sign-Translator は、スタジオ映像からレンダリングされたアバターまで、この問いを探究しています。その際、生成された動きと、言語学的に検証されたアメリカ手話(ASL)とは明確に区別しています。その出力を評価したろうの手話者はまだおらず、プロジェクトでは結果を示すすべての箇所でそのことを明記しています。
手のポーズのシーケンス以上のもの
手話は、手、体、顔、視線、タイミングを連携させます。このプロジェクトでは、それらすべてを一つの時計の上で表現します。毎秒 24 フレームの 11 チャンネルで、体と手の回転、頭の動き、52 個の表情係数、視線、まばたき、接触を扱います。各値には実際に観測されたかどうかの印が付いているため、欠損データは黙って補われることなく、見える形で残ります。
二台のカメラ、一つの骨格
動きは、正面と側面から撮影したスタジオ映像から得ています。姿勢推定器が各視点でキーポイントを検出します。視点どうしは手首と肘の動きで同期し、カメラは映像そのものから校正し、対応する点を三角測量して 3D にします。この段階での発見の一つは、両方のカメラが手話者に固定されている場合、幾何学的な情報だけでは焦点距離を復元できないということです。校正に剛体の骨の長さの項を加えたことで、焦点距離の誤差は 40〜47% から 1% 以内に収まりました。
動きの語彙
残差ベクトル量子化器は、各フレームを 32 個の離散コードに変換します。体の四つの部位(体、左手、右手、顔)を、それぞれ 8 段階で精緻化するものです。部位ごとに分けることで、単一の座標列ではぼやけてしまう違いが保たれます。また、単一のコードブックから残差方式に移行したことで、再構成誤差は約 19° と 11 cm から、約 8° と 2 cm に減りました。
うまくいかなかったこと、そしてその代わりになったもの
当初の計画は、テキストから一文分の動きを一度に生成することでした。しかし、プロジェクトの計測手段では、どのエンドツーエンドの生成モデルも、動きのない入力と区別できませんでした。現在の方法は合成方式です。単語ごとに別々に生成し、それぞれ 16 回サンプリングして、認識器が最もよく読み取れたサンプルを残し、予測したタイミングで単語をつなぎます。出力は英語の語順に従っており、これは ASL の文法ではありません。プロジェクトではそのことを明記しています。
計器を読む
生成された動きは英語に翻訳し直し、元の文と比較して採点します。その際は必ず、実際の手話、動きのない入力、順序をシャッフルしたもの、別の文という対照と並べます。一度だけ読む新しい文のセットでは、合成方式が 2.40、実際の手話が 4.03、動きのない入力が 2.05 でした。目標は 2.55 でしたが届かず、再試行せずにその結果を公開しました。
言語はパイプライン全体にわたって存続しなければならない。
- 01
モーションを 1 つの時計に乗せる
How2Sign の正面と側面の映像を特徴点の動きで同期し、カメラを校正し、位置を三角測量し、関節の回転を当てはめます。再投影と剛体の骨によるチェックが、再構成を制約します。これらはモーションキャプチャの正解データではなく、映像から得た推定値であり、その出どころも記録しています。
- 02
座標ではなく、コードを予測する
自己回帰型の Transformer が、テキストから残差コードを予測します。構成は、フレームにわたる因果的な時間モデル、バイト単位のテキストエンコーダ、そして 8 段階にわたる小さな深さ方向のモデルです。初期の自由生成サンプルは、1 ステップ予測から期待されるよりもはるかに認識されにくいものでした。トリミング、履歴のドロップアウト、マスク付き損失によって、単独の単語ではその差の大部分が解消されました。
- 03
スコアが何を測定しているかをテストする
以前の検索型の評価器は、回転をゼロにした動きにも驚くほど高いスコアを付けていました。クリップの長さが答えを漏らしていたのです。2 秒の固定ウィンドウ、ランダム化したオフセット、長さだけを使う対照によって、その近道を検証できるようにしました。以後のすべての計測手段にも、生成モデルの採点を任せる前に、同じ疑いの目を向けています。
公開の基準は、人による評価の前に固定しました。ろうの評価者が、生成された文を少なくとも 70% の割合で理解でき、かつ実際の手話との差が 10 ポイント以内であることです。この調査は設計済みですが、まだ実施していません。実施されるまでは、ここにあるどれも、理解可能な ASL であるという主張を裏付けるものではありません。
連続トレーニング実験を読む正直な限界。
- 生成された動きを評価したろうの手話者はまだいません。自動スコアはあくまで代理指標であり、理解度ではありません。
- 出力は英語の語順に従っており、ASL の文法はモデル化していません。
- モデルの重みは公開しておらず、このシステムは実用化された翻訳ツールではありません。
観察から動きへ。
英語音声。キャプションは 10 のサイト言語すべてで利用できます。翻訳は機械支援されています。
記録を読む
00:00 こうした好奇心が、Sign-Translator につながりました。
00:03 二つのカメラから伸びる線が各関節で交わり、その三次元位置が求まります。
00:08 骨の長さが変わらないという制約を使い、焦点距離の誤差を 40% 超から 1% 以内に減らしました。
00:14 動きを語彙のようなコードに圧縮し、Transformer が英語からそのコードを生成します。
00:21 ところが、その後はほぼすべてが失敗しました。
00:22 文全体の動きを生成するモデルは、静止した状態よりも意味を伝えられませんでした。
00:26 あるモデルは 95 項目すべての動作チェックに合格しても、文の意味を伝えられませんでした。
00:32 そこで現在は、単語ごとに動きを生成してクリップをつないでいます。
00:37 知らない単語は、そのまま抜け落ちます。
00:39 評価では、モデルが動きを英語に読み戻します。
00:43 動きのない入力は 2.05 点、生成した動きは 2.4 点、実際の手話は約 4 点です。
00:49 小さな改善ですが、一歩目です。
00:51 ご視聴ありがとうございました。
再生を開始できませんでした。ビデオ コントロールを試すか、ビデオをダウンロードしてください。
私のポートフォリオフィルムからの抜粋:手のランドマーク、再構成、生成された動き、および評価の限界。レンダリングされたアバターと自動スコアは、進行中の研究作業を示しています。手話の理解度を確立するものではありません。
言葉から
へ 動き。
ポーズはあくまで
始まり。
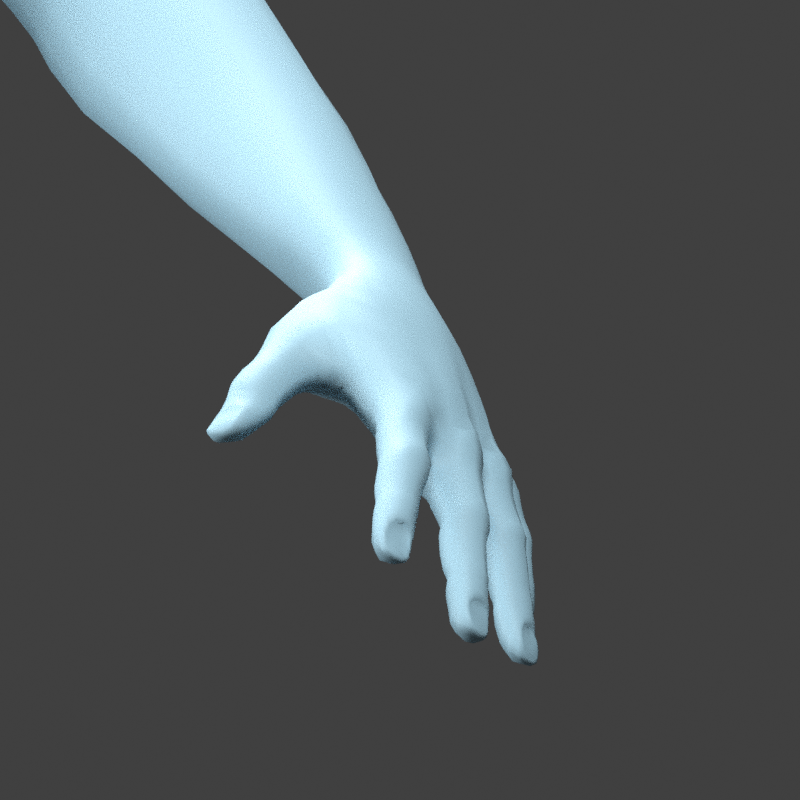
モーション モデルは最終的にボディを駆動する必要があります。このオリジナルの手関節レンダリングは、アバターの背後にあるジオメトリとジョイントの動作を詳しく調べるリポジトリのリグ チェックから得られます。
静的リグテスト。翻訳文を描いたものではありません。
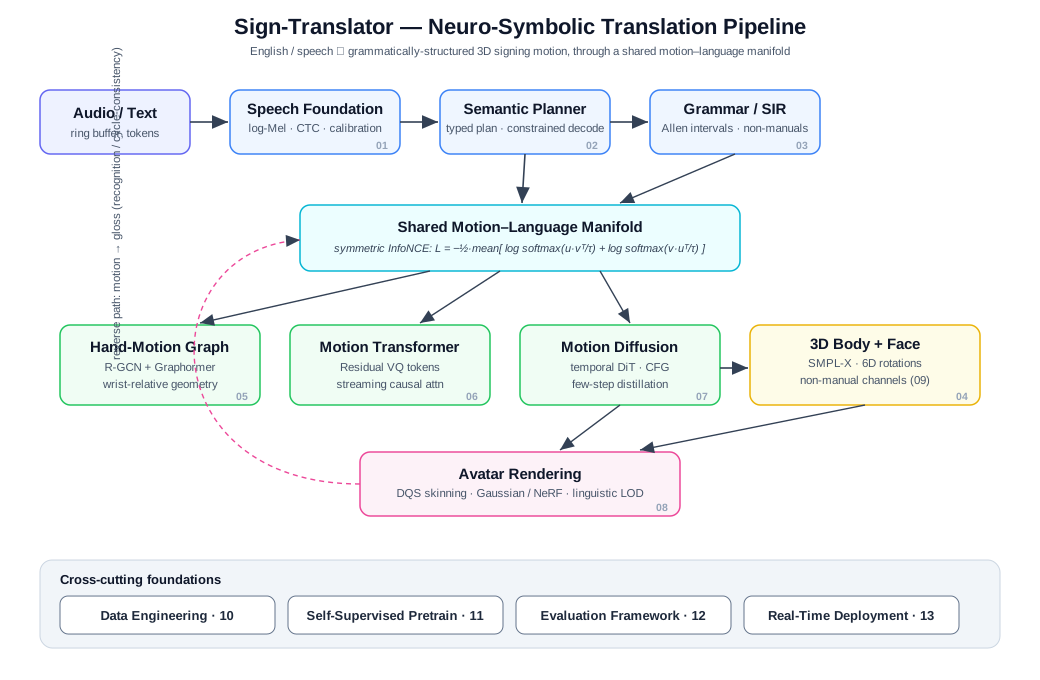
システムとその境界。
リポジトリのアーキテクチャマップは、実行可能な合成コアをより大きな翻訳設計から分離する。上で説明した新しい連続動作実験は、別のトレーニング パスに従います。
フルサイズの図を表示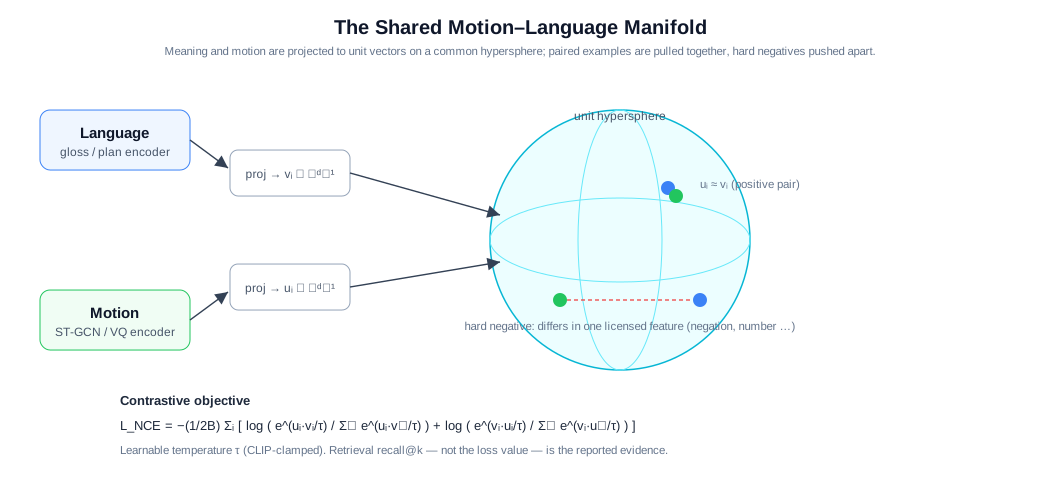
言語と運動は出会うことができるでしょうか?
時空間グラフネットワークは、関節の動きを符号化する。言語ベクトルと動きベクトルは正規化され、対称的なコントラスト損失に合わせて調整されます。つまり、一致するペアは不一致のペアよりも近くなる必要があります。検索テストでは、その整合性を調査します。
フルサイズの図を表示さらなる探求条件付き拡散がどのように設計されたか
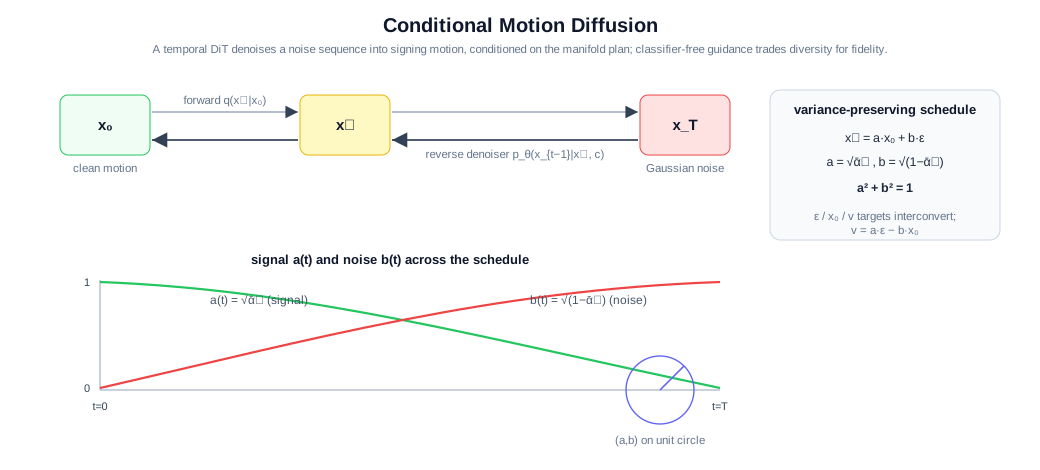
生成的仮説。
この図は、条件付き拡散研究設計を文書化したものである。継続的な実験により、ほぼ静的な故障モードが明らかになりました。選択された連続デコーダは、代わりに離散モーション コードを使用します。
フルサイズの図を表示さらなる探求ストリーミングモーションに必要なもの
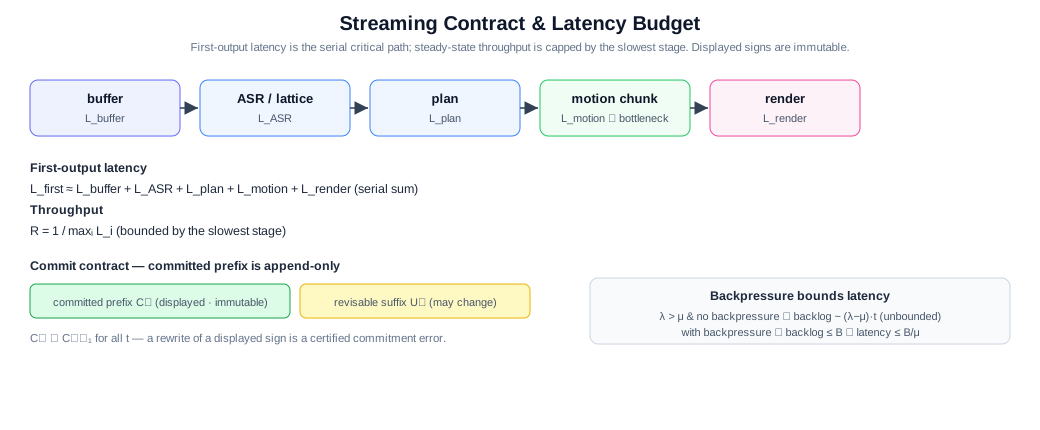
タイミングはインターフェースの一部である。
ストリーミング契約は、最初の出力までの時間を持続的なスループットから区別する。また、追加専用のコミットされたプレフィックスを指定するため、後の予測ですでに表示されているモーションを書き換えることはできません。これは設計上の契約であり、実稼働レイテンシの測定による主張ではありません。
フルサイズの図を表示