Le langage en mouvement
Etudier la distance entre les mots et la signature.
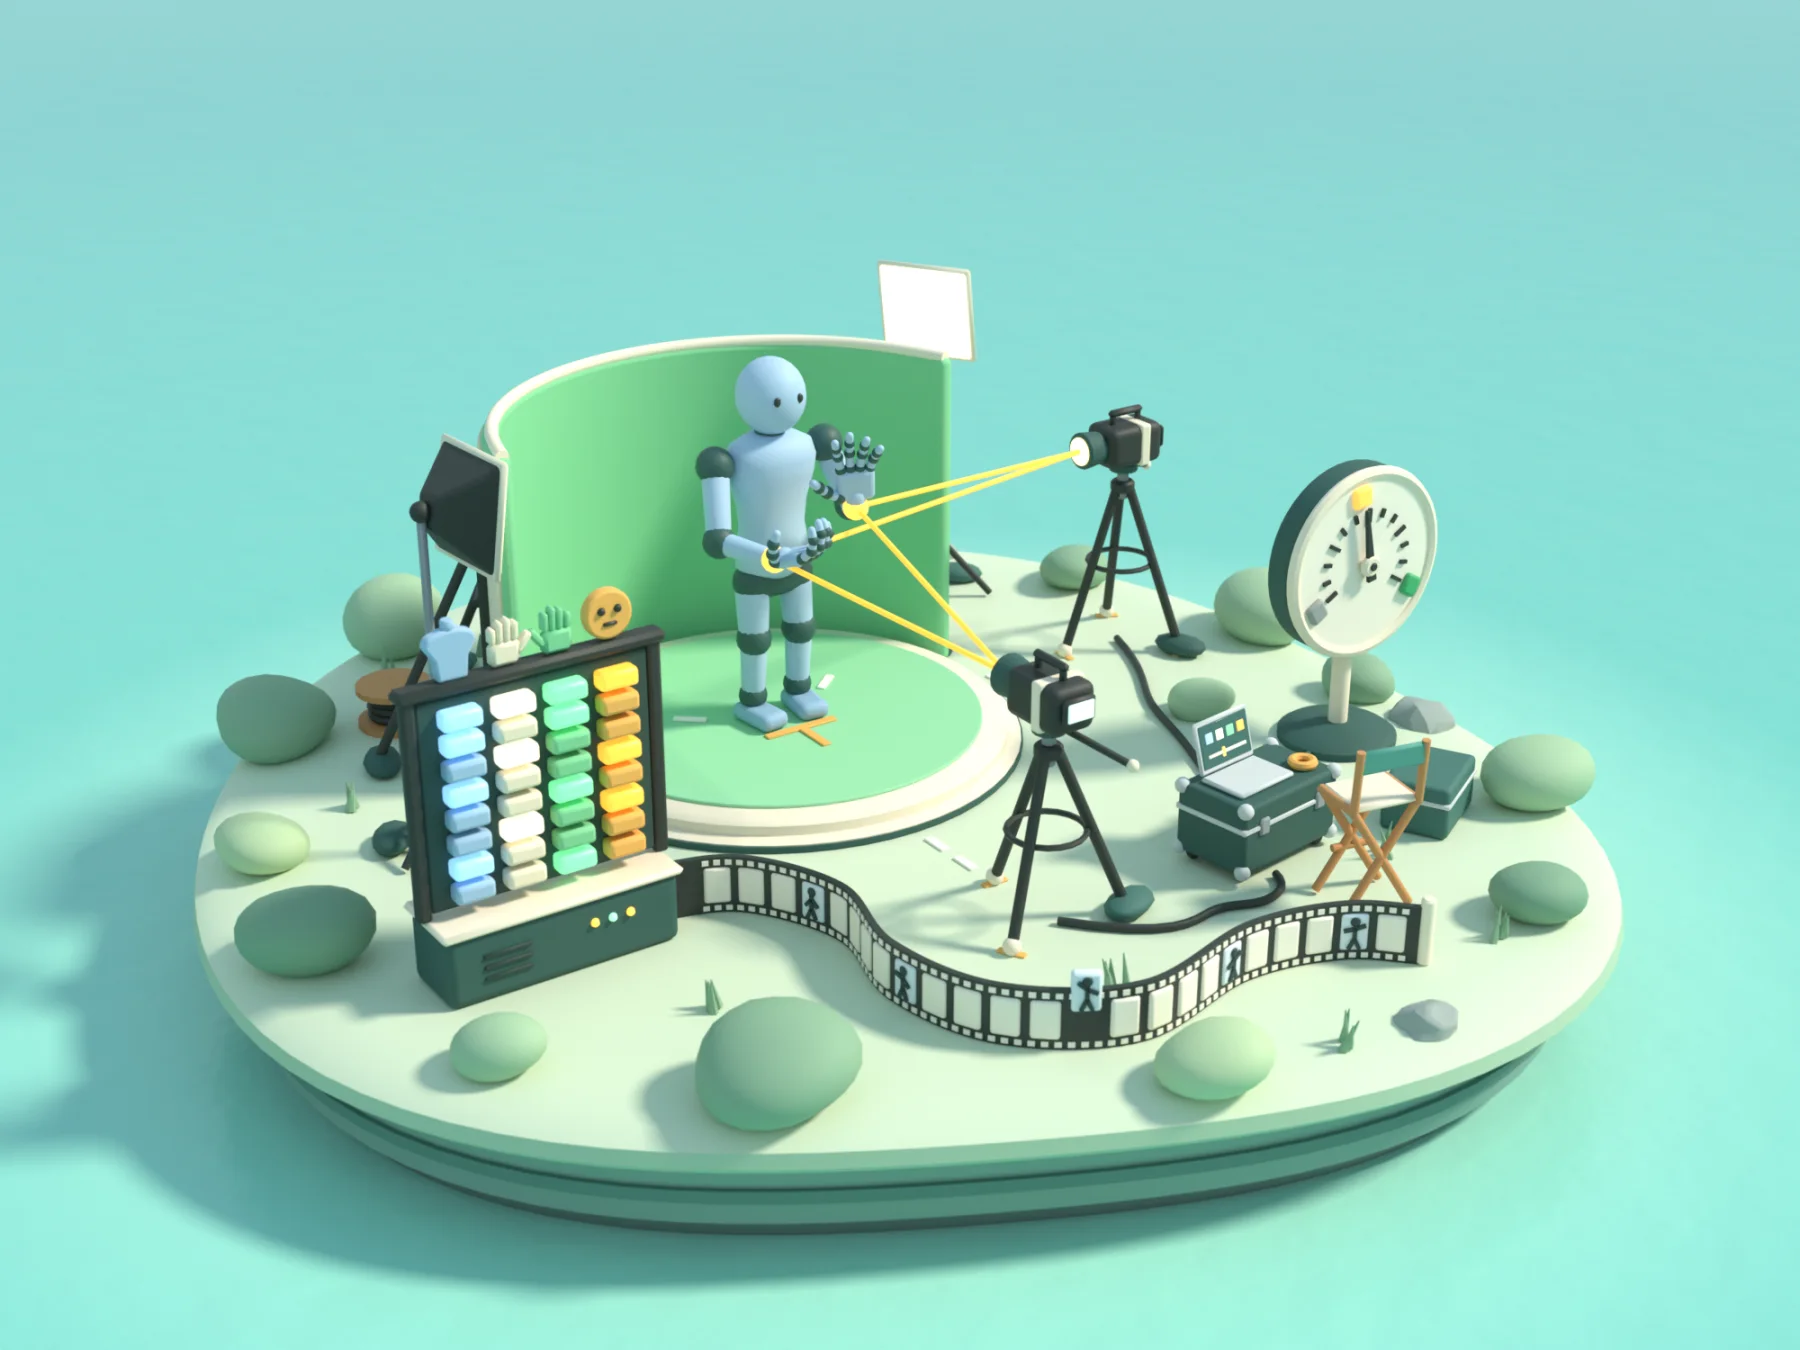
Un studio de capture, et les instruments qui garantissent son honnêteté.
Une illustration créée pour ce site dans Blender. Elle explique l’idée ; ce ne sont pas des données du projet.
Les images, schémas et vidéos d’origine conservent leur langue originale.
Rendre l’enseignement scientifique plus accessible m’a conduit à une question de recherche difficile : comment relier le langage à un mouvement coordonné ? Sign-Translator explore cette question, de la vidéo de studio jusqu’au rendu d’un avatar, en maintenant la distinction entre mouvement généré et langue des signes américaine (ASL) validée sur le plan linguistique. Aucune personne sourde signante n’a encore évalué ses résultats, et le projet le précise partout où un résultat apparaît.
Plus qu'une séquence de poses de mains
Signer mobilise à la fois les mains, le corps, le visage, le regard et le rythme. Le projet les représente tous sur une même horloge : onze canaux à 24 images par seconde, couvrant les rotations du corps et des mains, les mouvements de la tête, 52 coefficients faciaux, le regard, le clignement des yeux et le contact. Chaque valeur porte une marque indiquant si elle a réellement été observée, de sorte que les données manquantes restent visibles au lieu d’être comblées en silence.
Deux caméras, un squelette
Le mouvement provient de vidéos de studio filmées de face et de profil. Un estimateur de pose repère des points clés dans chaque vue ; les vues sont synchronisées grâce au mouvement des poignets et des coudes, les caméras sont calibrées à partir des images elles-mêmes, et les points correspondants sont triangulés en 3D. Un constat issu de cette étape : avec les deux caméras fixées sur la personne qui signe, la distance focale ne peut pas être retrouvée à partir de la seule géométrie. L’ajout à la calibration d’un terme de longueur d’os rigide a ramené l’erreur sur la focale de 40–47 % à moins de 1 %.
Un vocabulaire du mouvement
Un quantificateur vectoriel résiduel transforme chaque trame en 32 codes discrets : quatre parties du corps (corps, main gauche, main droite, visage), affinées chacune en huit étapes. Le découpage par partie préserve des distinctions qu’un flux unique de coordonnées brouillerait, et le passage d’un dictionnaire unique à la conception résiduelle a réduit l’erreur de reconstruction d’environ 19° et 11 cm à environ 8° et 2 cm.
Ce qui n’a pas marché, et ce qui l’a remplacé
Le premier plan consistait à générer d’un seul coup le mouvement de toute une phrase à partir du texte. Sur les instruments du projet, aucun générateur de bout en bout ne s’est distingué du mouvement vide. La voie actuelle est la composition : générer chaque mot séparément, l’échantillonner seize fois, garder l’échantillon qu’un système de reconnaissance lit le mieux, et enchaîner les mots avec un minutage prédit. Le résultat suit l’ordre des mots de l’anglais, qui n’est pas la grammaire de l’ASL, et le projet l’indique clairement.
Lire la jauge
Le mouvement généré est évalué en le retraduisant en anglais et en le comparant à la phrase source, toujours à côté de contrôles : des signes réels, un mouvement vide, un ordre mélangé et la mauvaise phrase. Sur un nouveau jeu de phrases évalué une seule fois, la composition a obtenu 2,40, les signes réels 4,03 et le mouvement vide 2,05. Le jalon était fixé à 2,55. Il n’a pas été atteint, et le résultat a été publié sans nouvelle tentative.
La langue doit survivre tout au long du pipeline.
- 01
Mettez le mouvement sur une horloge
Les vidéos How2Sign de face et de profil sont alignées grâce au mouvement des points de repère, puis les caméras sont calibrées, les positions triangulées et les rotations articulaires ajustées. Des contrôles de reprojection et de rigidité des os contraignent la reconstruction. Il s’agit d’estimations dérivées de vidéos, dont la provenance est conservée, et non d’une vérité terrain issue de capture de mouvement.
- 02
Prédire des codes, pas des coordonnées
Un transformer autorégressif prédit les codes résiduels à partir du texte : un modèle temporel causal sur les trames, un encodeur de texte au niveau de l’octet et un modèle de profondeur plus petit sur les huit étapes. Les premiers échantillons générés en boucle libre étaient bien moins souvent reconnus que ne le laissaient penser les prédictions à un pas ; le découpage, le dropout de l’historique et des pertes masquées ont comblé l’essentiel de cet écart pour les mots isolés.
- 03
Tester ce que mesure le score
Un ancien évaluateur par recherche notait étonnamment bien un mouvement aux rotations mises à zéro : la durée du clip trahissait la réponse. Des fenêtres fixes de deux secondes, des décalages aléatoires et un contrôle fondé sur la seule durée ont rendu ce raccourci testable. La même méfiance s’applique à chaque instrument ultérieur avant qu’il ne soit autorisé à noter le générateur.
Le seuil de publication a été fixé avant toute évaluation humaine : les évaluateurs sourds doivent comprendre les phrases générées au moins 70 % du temps, et à moins de dix points des signes réels. Cette étude a été conçue mais n’a pas encore été menée. D’ici là, rien ici ne permet d’affirmer que l’ASL produite est compréhensible.
Lire les expériences de formation continueLes limites, en toute honnêteté.
- Aucune personne sourde signante n’a évalué le mouvement généré. Les scores automatiques sont un indicateur indirect, et non une mesure de la compréhension.
- Le résultat suit l’ordre des mots de l’anglais et ne modélise pas la grammaire de l’ASL.
- Les poids du modèle ne sont pas publiés, et le système n’est pas un traducteur déployé.
Des observations au mouvement.
Audio en anglais. Les sous-titres sont disponibles dans les dix langues du site ; les traductions sont assistées par machine.
Lire la transcription
00:00 Toute cette curiosité m'a conduit à Sign-Translator.
00:03 Les lignes issues de deux caméras se croisent à chaque articulation, ce qui donne sa position en 3D.
00:08 La longueur constante des os a permis de ramener l’erreur sur la distance focale de plus de 40 % à moins de 1 %.
00:14 Le mouvement est comprimé en codes, comme un vocabulaire, qu’un Transformer génère à partir de l’anglais.
00:21 Puis presque tout a échoué.
00:22 Les modèles générant des phrases entières ne transmettaient pas plus de sens qu’une figure immobile.
00:26 L’un a réussi les 95 tests de mouvement, sans pour autant parvenir à transmettre une phrase.
00:32 Désormais, le système génère chaque mot séparément et assemble les clips ensemble.
00:37 Les mots qu'il ne connaît pas disparaissent tout simplement.
00:39 Pour le noter, un modèle relit le mouvement en anglais.
00:43 L’absence de mouvement obtient 2,05, le mouvement généré 2,4, et la vraie langue des signes environ 4.
00:49 C'est un gain mince, mais c'est un début.
00:51 Merci d'avoir regardé.
La lecture n'a pas pu démarrer. Essayez les commandes vidéo ou téléchargez la vidéo.
Un extrait de mon portfolio filmé : repères de main, reconstruction, mouvement généré et limites d'évaluation. L'avatar rendu et les scores automatiques démontrent les travaux de recherche en cours ; ils n'établissent pas l'intelligibilité de la langue des signes.
A partir de mots
à mouvement.
Une pose est seulement
le début.
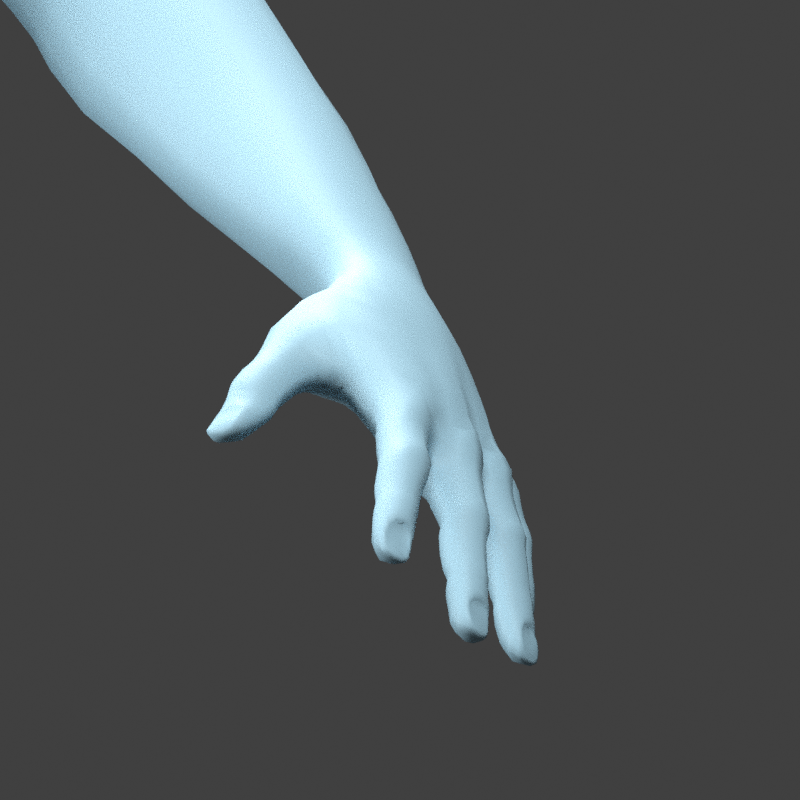
Un modèle de mouvement doit finalement conduire un corps. Ce rendu original d'articulation de la main provient des vérifications du rig du référentiel : un examen attentif de la géométrie et du comportement des articulations derrière un avatar.
Test au banc statique. Il ne représente pas une phrase traduite.
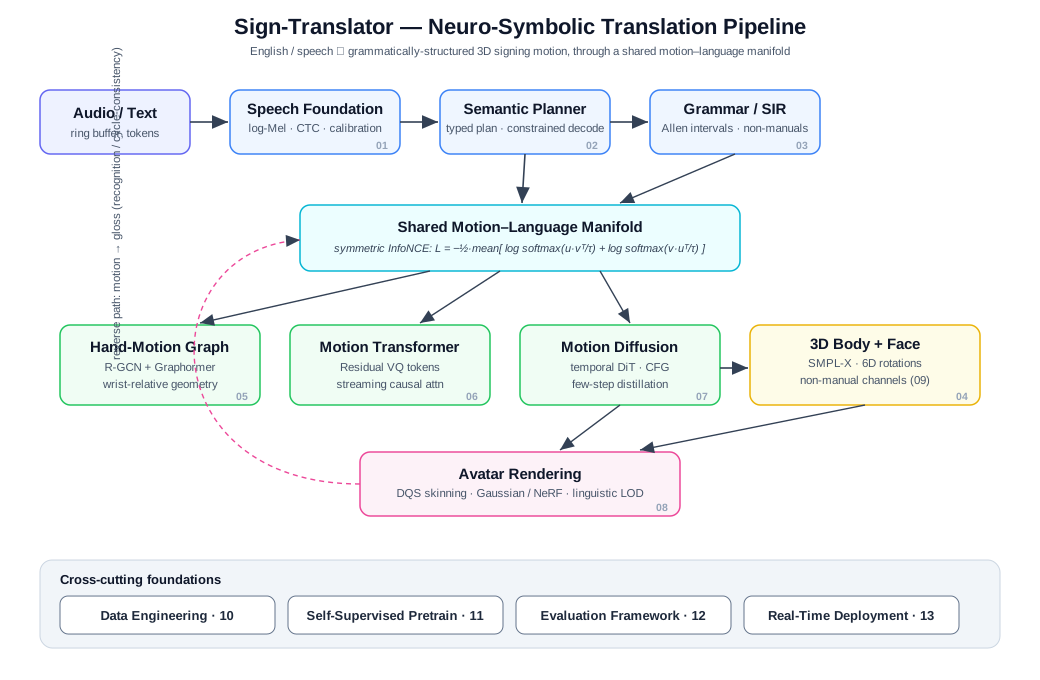
Le système et ses limites.
La carte architecturale du référentiel sépare le noyau synthétique exécutable de la conception de traduction plus large. Les nouvelles expériences en mouvement continu décrites ci-dessus suivent un parcours de formation distinct.
Afficher le diagramme en taille réelle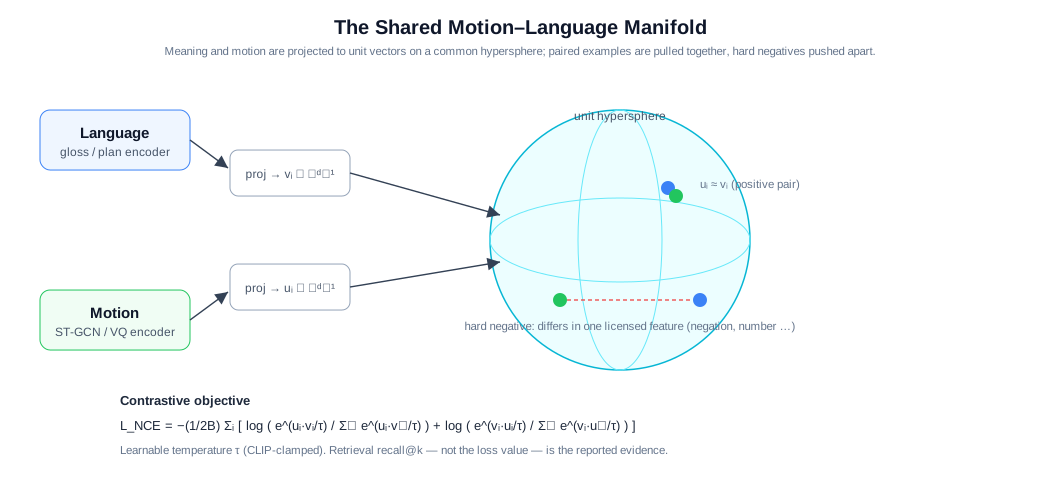
Langage et mouvement peuvent-ils se rencontrer ?
Un réseau de graphes spatio-temporels code le mouvement des articulations. Les vecteurs de langage et de mouvement sont normalisés et alignés avec une perte contrastive symétrique : les paires correspondantes doivent être plus proches que celles qui ne correspondent pas. Les tests de récupération sondent cet alignement.
Afficher le diagramme en taille réelleExploration plus approfondieComment la diffusion conditionnelle a été conçue
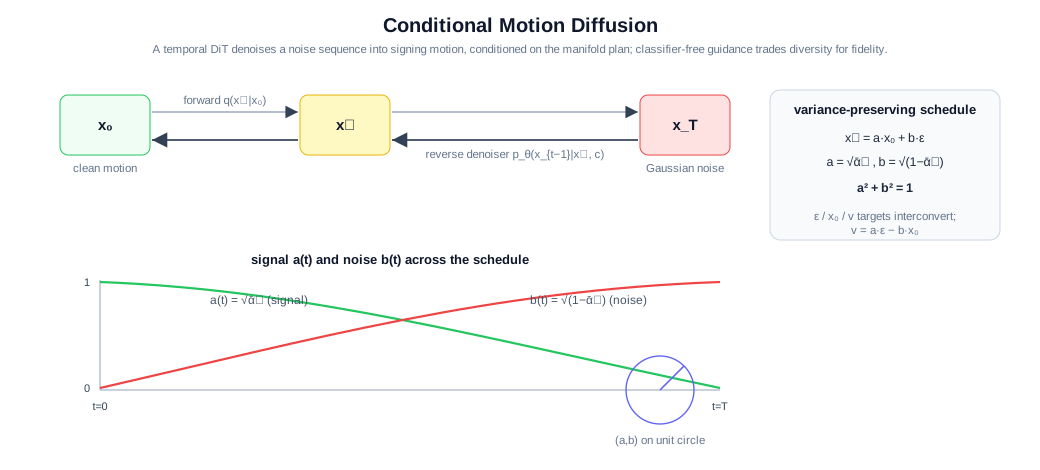
Une hypothèse générative.
Ce diagramme documente la conception de la recherche en diffusion conditionnelle. Les expériences continues ont révélé un mode de défaillance quasi statique ; le décodeur continu sélectionné utilise à la place des codes de mouvement discrets.
Afficher le diagramme en taille réelleExploration plus approfondieCe que nécessite le mouvement en streaming
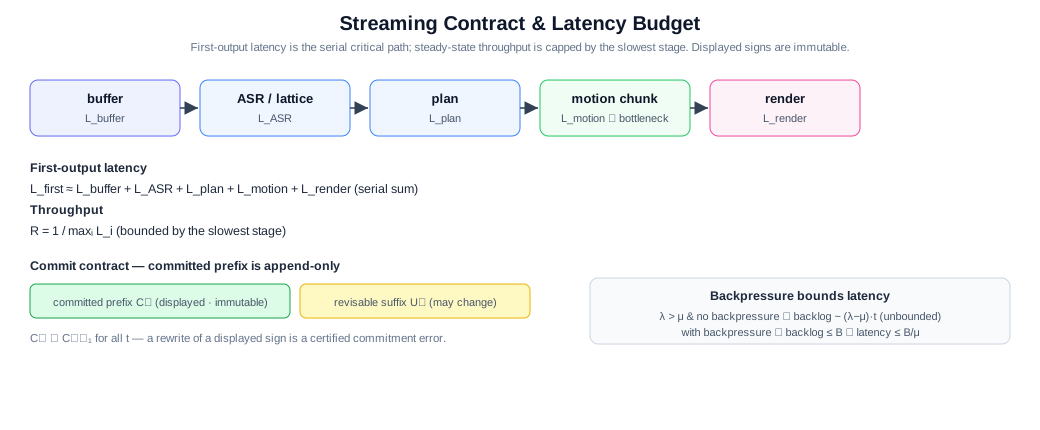
Le timing fait partie de l’interface.
Le contrat de streaming distingue le délai jusqu'à la première sortie du débit soutenu. Il spécifie également un préfixe validé en ajout uniquement afin qu'une prédiction ultérieure ne puisse pas réécrire le mouvement déjà affiché. Il s’agit d’un contrat de conception et non d’une réclamation de latence de production mesurée.
Afficher le diagramme en taille réelleCe qui relie ce projet aux autres.
 Trouver le capLes deux pilotent un corps physique dans ses limites : un gouvernail là-bas, trente articulations des doigts ici.
 Mieux évaluer un agentLa même méfiance envers les évaluateurs : vérifier l’instrument avant qu’il ne note quoi que ce soit.
 CollegeAdvisorLes deux préfèrent s’abstenir plutôt que de donner une réponse assurée que les éléments ne justifient pas.
Prototype de recherche en cours. Les schémas ci-dessous documentent des étapes antérieures de la conception de la recherche, et l’image de la main est un test du rig. Ni la génération de mouvement ni une vérification du rendu ne démontrent la validité linguistique en ASL. Une évaluation indépendante de l’intelligibilité reste nécessaire. Vidéo de studio : How2Sign (CC BY-NC 4.0).