Sprache in Bewegung
Untersuchung des Abstands zwischen Wörtern und Gebärden.
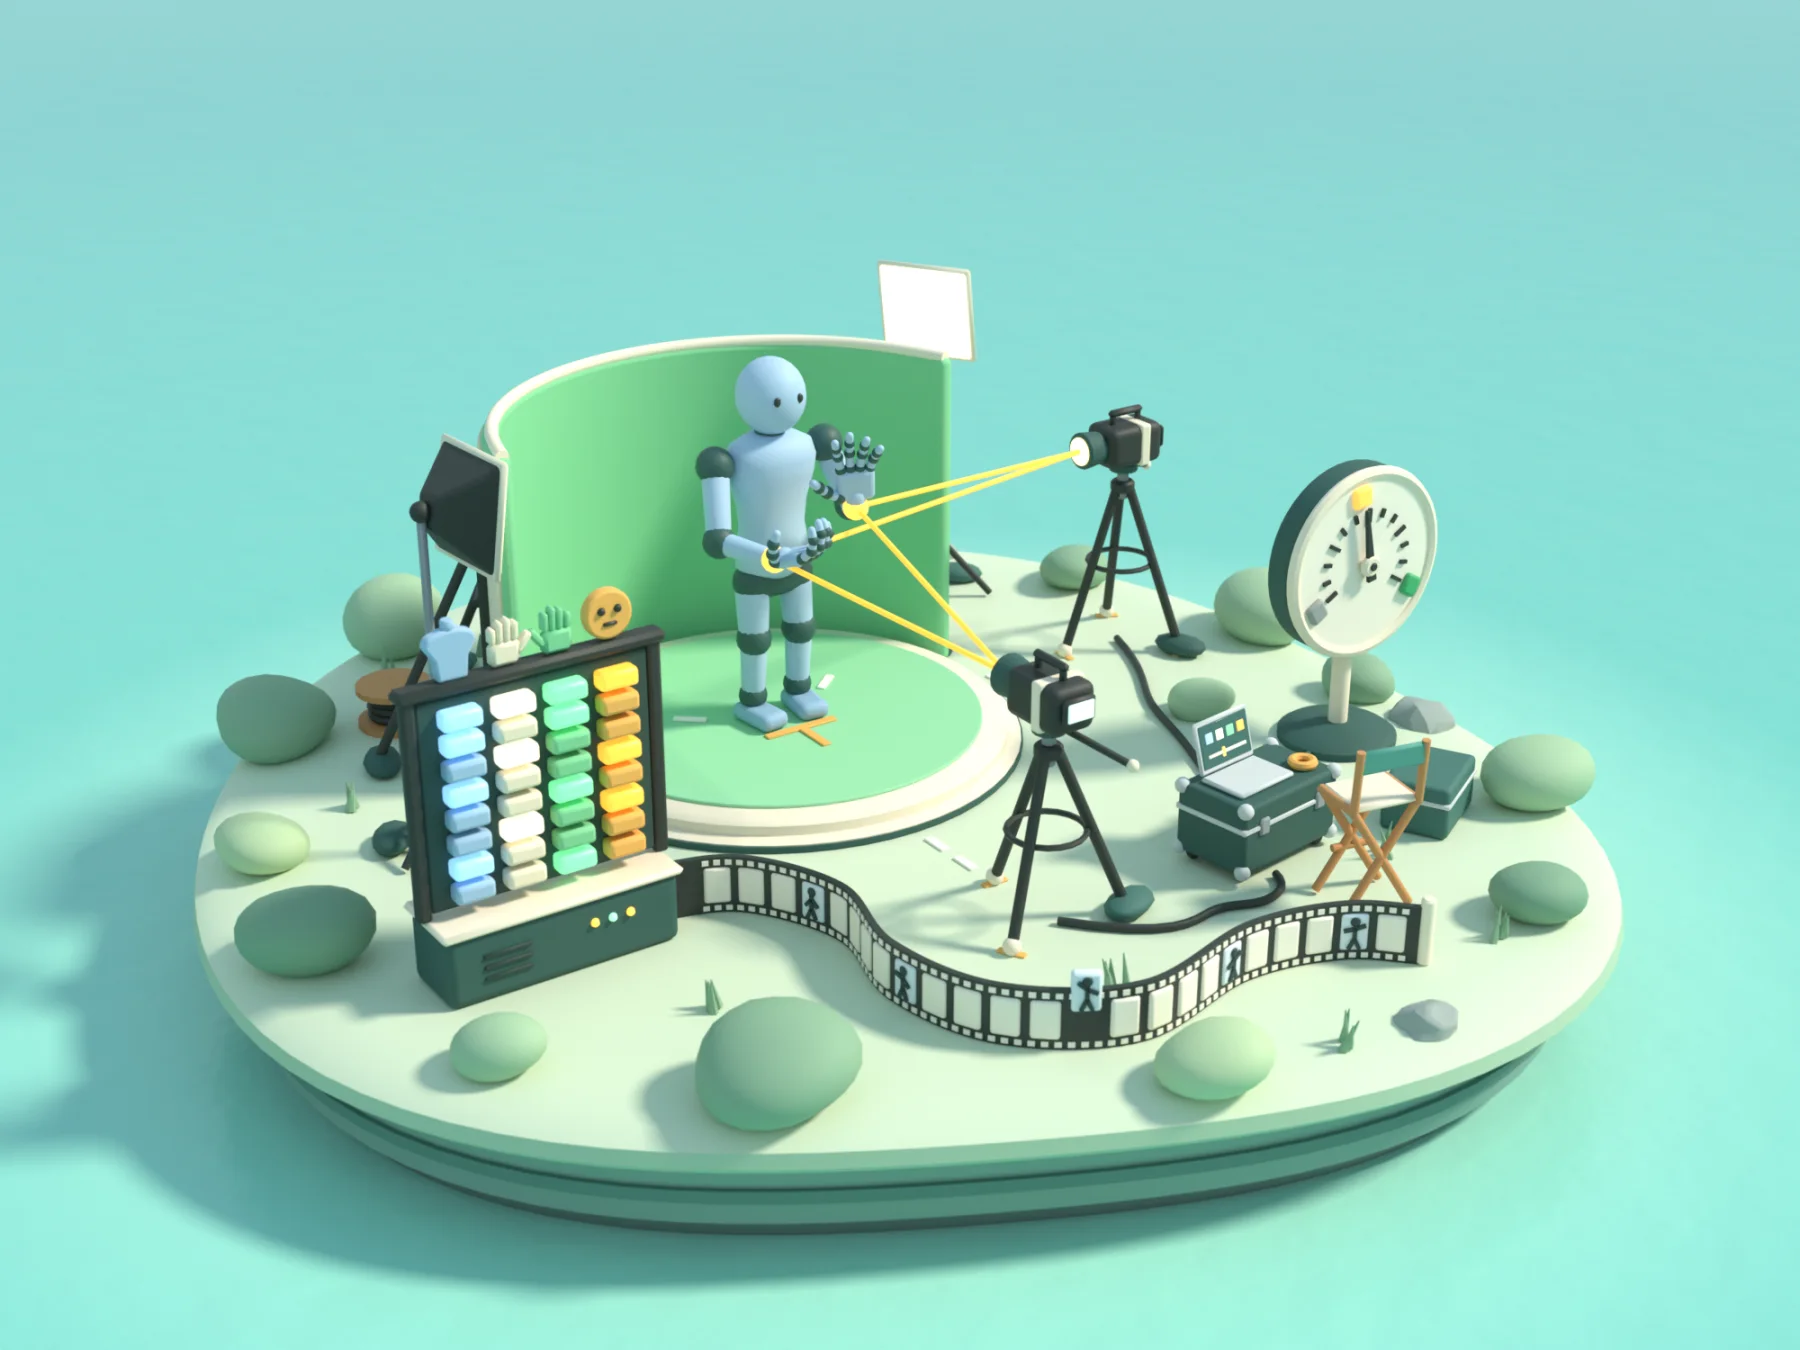
Ein Aufnahmestudio und die Instrumente, die es ehrlich halten.
Eine für diese Website in Blender gebaute Illustration. Sie erklärt die Idee; es sind keine Daten aus dem Projekt.
Originalbilder, Diagramme und Videos bleiben in ihrer Ausgangssprache.
Der Wunsch, naturwissenschaftliche Bildung zugänglicher zu machen, führte mich zu einer schwierigen Forschungsfrage: Wie kann Sprache mit koordinierter Bewegung verbunden werden? Sign-Translator verfolgt diese Frage vom Studiovideo bis zum gerenderten Avatar und hält generierte Bewegung dabei klar getrennt von sprachlich validierter Amerikanischer Gebärdensprache. Noch hat keine taube gebärdende Person die Ausgabe beurteilt, und das Projekt sagt das überall dort, wo ein Ergebnis erscheint.
Mehr als eine Abfolge von Handposen
Gebärden koordiniert Hände, Körper, Gesicht, Blick und Timing. Das Projekt bildet all das auf einer gemeinsamen Uhr ab: elf Kanäle mit 24 Frames pro Sekunde, die Körper- und Handrotationen, Kopfbewegung, 52 Gesichtskoeffizienten, Blick, Blinzeln und Kontakt abdecken. Jeder Wert trägt eine Markierung, ob er tatsächlich beobachtet wurde, sodass fehlende Daten sichtbar bleiben, statt stillschweigend aufgefüllt zu werden.
Zwei Kameras, ein Skelett
Die Bewegung stammt aus Studiovideos, die von vorn und von der Seite gefilmt wurden. Ein Pose-Schätzer findet in jeder Ansicht Keypoints; die Ansichten werden über die Bewegung von Handgelenken und Ellbogen synchronisiert, die Kameras aus dem Material selbst kalibriert, und übereinstimmende Punkte werden in 3D trianguliert. Eine Erkenntnis aus dieser Phase: Sind beide Kameras fest auf die gebärdende Person gerichtet, lässt sich die Brennweite nicht allein aus der Geometrie bestimmen. Ein Term für starre Knochenlängen in der Kalibrierung senkte den Brennweitenfehler von 40–47 % auf unter 1 %.
Ein Vokabular der Bewegung
Ein residualer Vektorquantisierer wandelt jedes Frame in 32 diskrete Codes um: vier Körperteile (Körper, linke Hand, rechte Hand, Gesicht), jeweils in acht Stufen verfeinert. Die Aufteilung nach Körperteilen bewahrt Unterschiede, die ein einzelner Koordinatenstrom verwischen würde, und der Wechsel von einem einzigen Codebook zum residualen Design senkte den Rekonstruktionsfehler von etwa 19° und 11 cm auf etwa 8° und 2 cm.
Was nicht funktioniert hat und was es ersetzt hat
Der ursprüngliche Plan war, einen ganzen Satz an Bewegung in einem Durchgang aus Text zu erzeugen. Auf den Messinstrumenten des Projekts hob sich kein End-to-End-Generator vom Stillstand ab. Der aktuelle Weg ist die Komposition: jedes Wort einzeln erzeugen, es sechzehnmal samplen, das Sample behalten, das ein Erkenner am besten liest, und die Wörter mit vorhergesagtem Timing verbinden. Die Ausgabe folgt der englischen Wortstellung, die nicht der ASL-Grammatik entspricht, und das Projekt sagt das offen.
Das Messinstrument ablesen
Generierte Bewegung wird bewertet, indem sie zurück ins Englische übersetzt und mit dem Ausgangssatz verglichen wird – stets neben Kontrollen: echtes Gebärden, Stillstand, vertauschte Reihenfolge und der falsche Satz. Auf neuen, genau einmal ausgewerteten Sätzen erzielte die Komposition 2,40, echtes Gebärden 4,03 und Stillstand 2,05. Der Meilenstein lag bei 2,55. Er wurde verfehlt, und das Ergebnis wurde ohne zweiten Versuch veröffentlicht.
Sprache muss die gesamte Pipeline überleben.
- 01
Setzen Sie die Bewegung auf eine Uhr
How2Sign-Videos von vorn und von der Seite werden anhand der Bewegung von Landmarken synchronisiert; danach werden die Kameras kalibriert, Positionen trianguliert und Gelenkrotationen angepasst. Reprojektions- und Starrknochen-Prüfungen schränken die Rekonstruktion ein. Es handelt sich um aus Video abgeleitete Schätzungen mit dokumentierter Herkunft, nicht um Motion-Capture-Ground-Truth.
- 02
Codes vorhersagen, nicht Koordinaten
Ein autoregressiver Transformer sagt die residualen Codes aus Text vorher: ein kausales zeitliches Modell über die Frames, ein Text-Encoder auf Byte-Ebene und ein kleineres Tiefenmodell über die acht Stufen. Frühe frei generierte Samples wurden weit seltener erkannt, als die Ein-Schritt-Vorhersagen vermuten ließen; Trimmen, History-Dropout und maskierte Verluste schlossen für einzelne Wörter den größten Teil dieser Lücke.
- 03
Testen Sie, was der Score misst
Ein früherer Retrieval-Evaluator bewertete Bewegung mit auf null gesetzten Rotationen überraschend gut: Die Cliplänge verriet die Antwort. Feste Zwei-Sekunden-Fenster, zufällige Versätze und eine Kontrolle, die nur die Dauer kennt, machten diese Abkürzung prüfbar. Mit demselben Misstrauen wird jedes spätere Messinstrument geprüft, bevor es den Generator bewerten darf.
Die Freigabeschwelle wurde vor jeder menschlichen Bewertung festgelegt: Taube Bewertende müssen generierte Sätze in mindestens 70 % der Fälle verstehen, und zwar höchstens zehn Punkte unter echtem Gebärden. Diese Studie ist geplant, aber noch nicht durchgeführt. Bis dahin stützt nichts hier die Aussage, es entstehe verständliche ASL.
Lesen Sie die Experimente zum kontinuierlichen TrainingDie ehrlichen Grenzen.
- Noch keine taube gebärdende Person hat die generierte Bewegung bewertet. Automatische Scores sind ein Näherungswert, kein Verstehen.
- Die Ausgabe folgt der englischen Wortstellung und modelliert keine ASL-Grammatik.
- Die Modellgewichte sind nicht veröffentlicht, und das System ist kein eingesetzter Übersetzer.
Von der Beobachtung zur Bewegung.
Englischer Ton. Untertitel sind in allen zehn Sprachen der Website verfügbar. Übersetzungen erfolgen maschinell.
Lesen Sie das Transkript
00:00 All diese Neugier führte mich zu Sign-Translator.
00:03 Linien von zwei Kameras treffen sich an jedem Gelenk und bestimmen dessen Position im dreidimensionalen Raum.
00:08 Die konstante Knochenlänge half, den Fehler der Brennweite von über 40 % auf unter 1 % zu senken.
00:14 Die Bewegung wird in Codes wie ein Vokabular komprimiert. Ein Transformer erzeugt diese Codes aus englischem Text.
00:21 Dann scheiterte fast alles.
00:22 Modelle für ganze Sätze vermittelten nicht mehr Bedeutung als eine stillstehende Figur.
00:26 Eines bestand alle 95 Bewegungstests und konnte trotzdem keinen Satz vermitteln.
00:32 Nun generiert das System jedes Wort separat und fügt die Clips zusammen.
00:37 Wörter, die es nicht kennt, verschwinden einfach.
00:39 Um es zu bewerten, liest ein Modell die Bewegung zurück ins Englische.
00:43 Ohne Bewegung liegt der Wert bei 2,05, für erzeugte Bewegung bei 2,4 und für echte Gebärdensprache bei etwa 4.
00:49 Eine kleine Verbesserung, aber ein Anfang.
00:51 Danke fürs Zuschauen.
Die Wiedergabe konnte nicht gestartet werden. Probieren Sie die Videosteuerung aus oder laden Sie das Video herunter.
Ein Auszug aus meinem Portfoliofilm: Handmarkierungen, Rekonstruktion, erzeugte Bewegung und Bewertungsbeschränkungen. Der gerenderte Avatar und die automatischen Partituren veranschaulichen die laufende Forschungsarbeit; Sie begründen keine Verständlichkeit der Gebärdensprache.
Aus Worten
bis Bewegung.
Eine Pose ist nur
der Anfang.
Ein Bewegungsmodell muss schließlich einen Körper antreiben. Dieses Original-Handartikulations-Rendering stammt aus den Rig-Checks des Repositorys: ein genauer Blick auf die Geometrie und das Gelenkverhalten hinter einem Avatar.
Statischer Prüfstandtest. Es handelt sich nicht um einen übersetzten Satz.
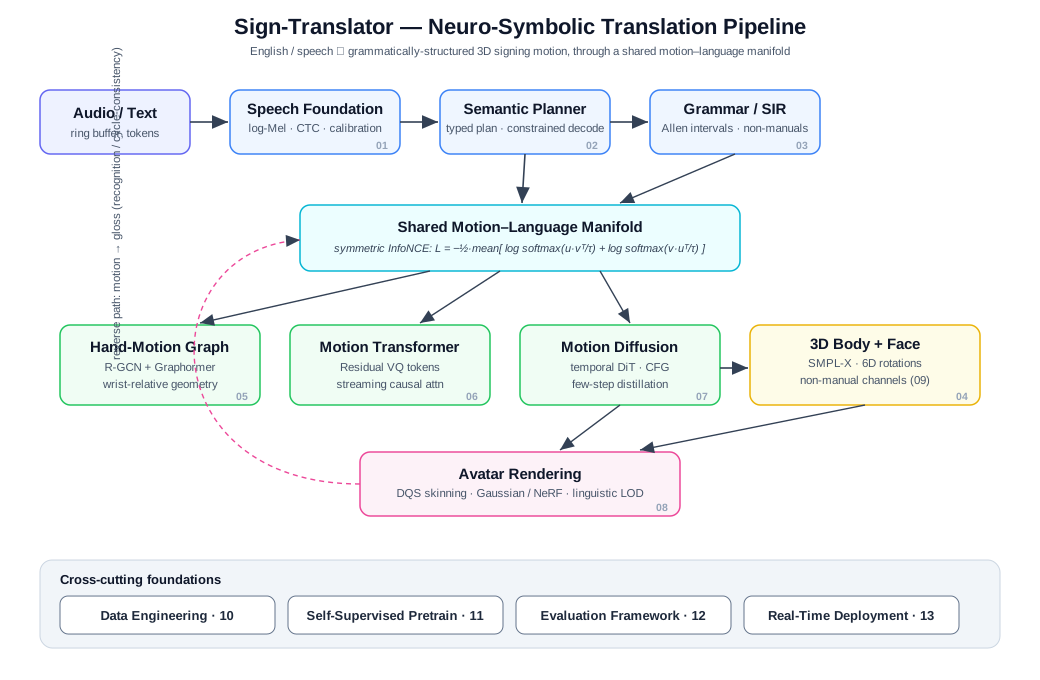
Das System und seine Grenzen.
Die Architekturkarte des Repositorys trennt den ausführbaren synthetischen Kern vom größeren Übersetzungsdesign. Die oben beschriebenen neueren Experimente mit kontinuierlicher Bewegung folgen einem separaten Trainingspfad.
Diagramm in voller Größe anzeigen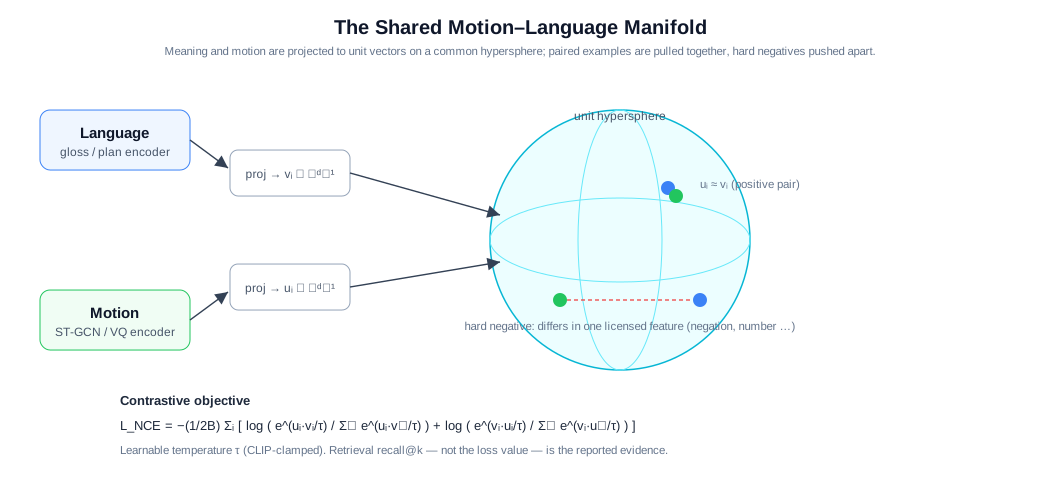
Können sich Sprache und Bewegung treffen?
Ein räumlich-zeitliches Graphennetzwerk kodiert die Gelenkbewegung. Sprach- und Bewegungsvektoren werden normalisiert und mit einem symmetrischen Kontrastverlust ausgerichtet: übereinstimmende Paare sollten näher beieinander liegen als nicht übereinstimmende. Retrieval-Tests prüfen diese Ausrichtung.
Diagramm in voller Größe anzeigenWeitere ErkundungWie die bedingte Diffusion konzipiert wurde
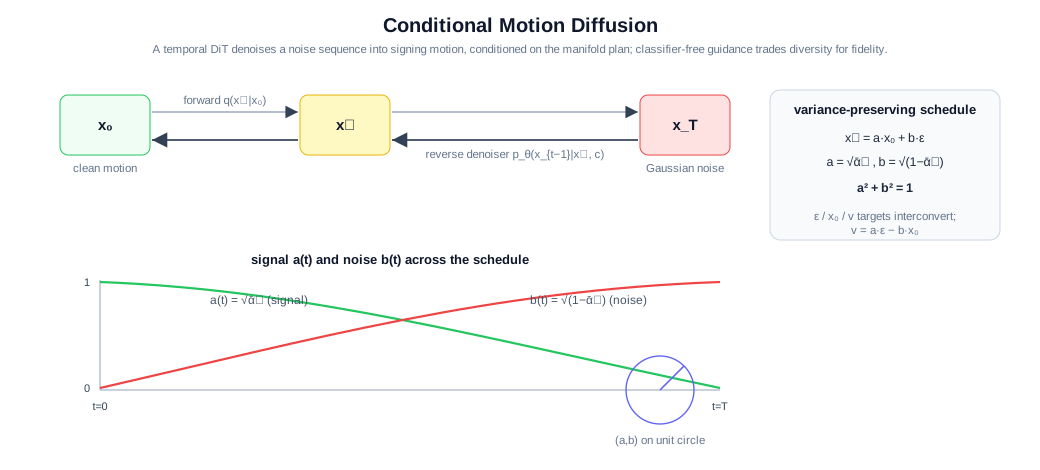
Eine generative Hypothese.
Dieses Diagramm dokumentiert das Forschungsdesign der bedingten Diffusion. Die kontinuierlichen Experimente deckten einen nahezu statischen Versagensmodus auf; Der ausgewählte kontinuierliche Decoder verwendet stattdessen diskrete Bewegungscodes.
Diagramm in voller Größe anzeigenWeitere ErkundungWas Streaming-Bewegung erfordert
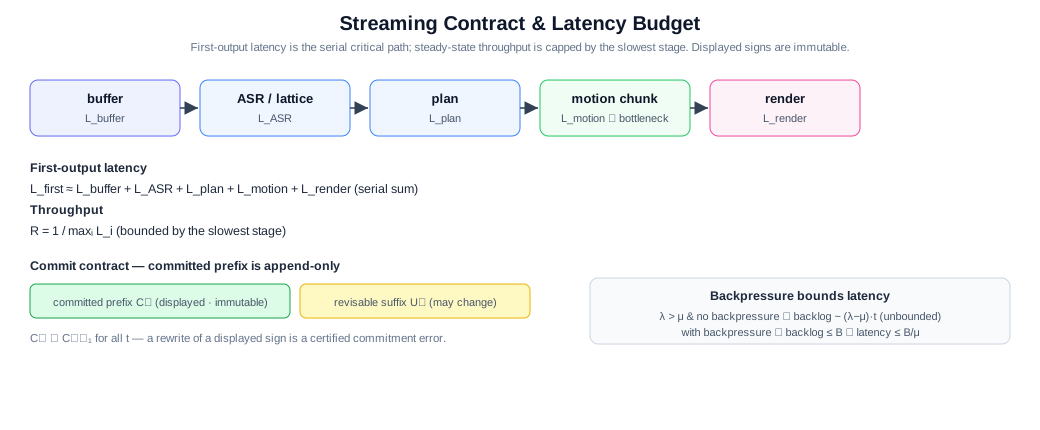
Das Timing ist Teil der Schnittstelle.
Der Streaming-Vertrag unterscheidet die Zeit bis zur ersten Ausgabe vom anhaltenden Durchsatz. Es gibt außerdem ein festgeschriebenes Präfix an, das nur zum Anhängen bestimmt ist, sodass eine spätere Vorhersage die bereits angezeigte Bewegung nicht neu schreiben kann. Hierbei handelt es sich um einen Designvertrag, nicht um einen Anspruch auf gemessene Produktionslatenz.
Diagramm in voller Größe anzeigenWo sich das verbindet.
 Den Kurs findenBeide steuern einen physischen Körper innerhalb seiner Grenzen: dort ein Ruder, hier dreißig Fingergelenke.
 Agenten besser bewertenDasselbe Misstrauen gegenüber Bewertern: das Messinstrument prüfen, bevor es irgendetwas bewertet.
 CollegeAdvisorBeide verzichten lieber auf eine Antwort, als eine selbstsichere Antwort zu geben, die die Belege nicht stützen.
Forschungsprototyp in Entwicklung. Die Diagramme unten dokumentieren frühere Teile des Forschungsdesigns; das Handbild ist ein Rig-Test. Weder generierte Bewegung noch eine Rendering-Prüfung belegen sprachlich gültige ASL. Eine unabhängige Bewertung der Verständlichkeit bleibt erforderlich. Studiovideo: How2Sign (CC BY-NC 4.0).