Lenguaje en movimiento
Estudio de la distancia entre palabras y signos.
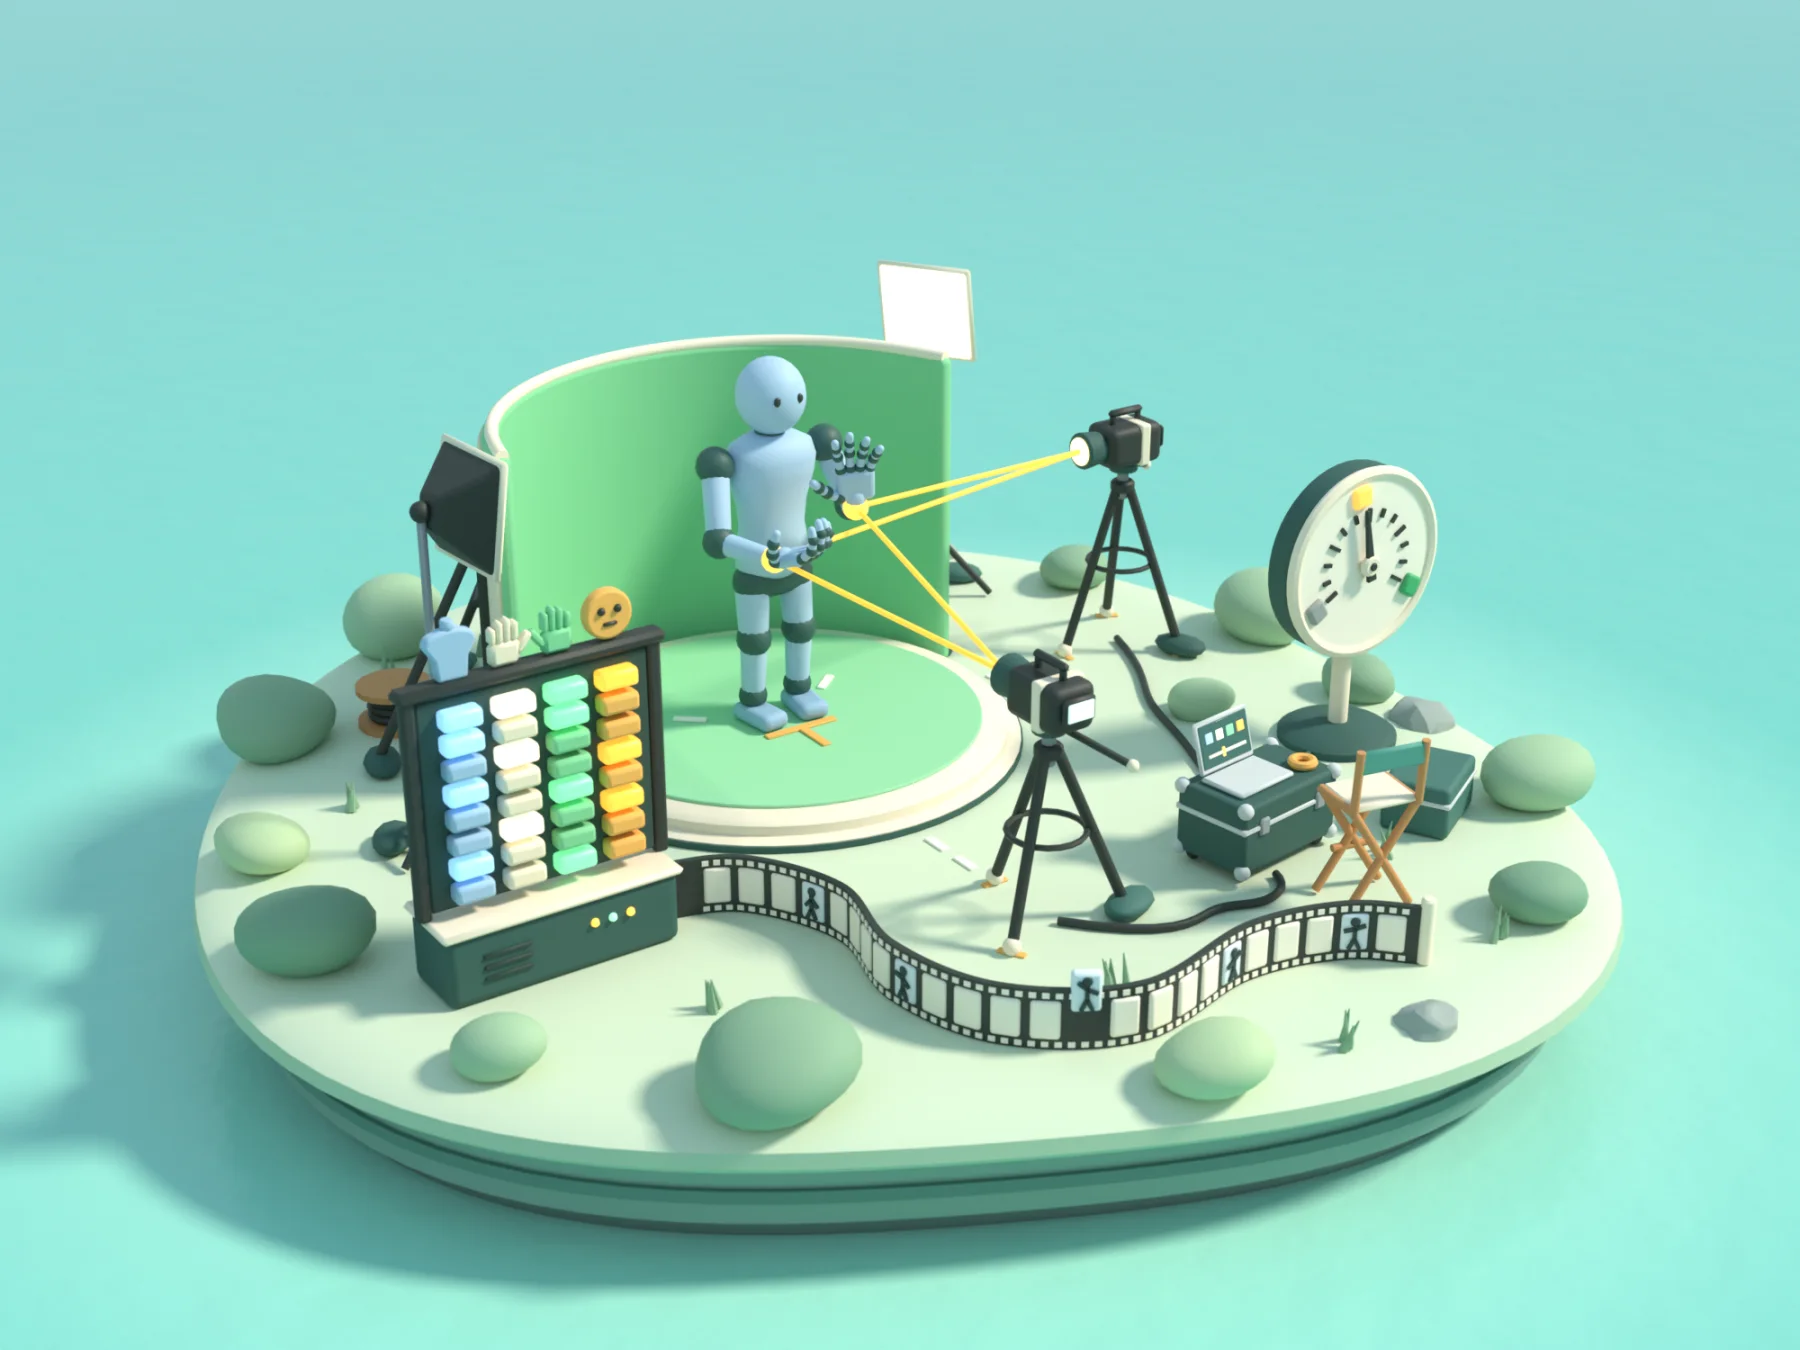
Un estudio de captura y los instrumentos que lo mantienen honesto.
Una ilustración creada en Blender para este sitio. Explica la idea; no son datos del proyecto.
Las imágenes, los diagramas y los vídeos originales conservan su idioma de origen.
Hacer más accesible la educación científica me llevó a una pregunta de investigación difícil: ¿cómo puede el lenguaje conectarse con el movimiento coordinado? Sign-Translator explora esa pregunta desde el vídeo de estudio hasta un avatar renderizado, manteniendo el movimiento generado separado de la Lengua de Señas Americana validada lingüísticamente. Ningún signante sordo ha evaluado aún sus resultados, y el proyecto lo indica allí donde aparece un resultado.
Más que una secuencia de posturas de manos
Las señas coordinan las manos, el cuerpo, la cara, la mirada y el ritmo. El proyecto los representa todos en un mismo reloj: once canales a 24 fotogramas por segundo, que cubren las rotaciones del cuerpo y las manos, el movimiento de la cabeza, 52 coeficientes faciales, la mirada, el parpadeo y el contacto. Cada valor lleva una marca que indica si realmente se observó, de modo que los datos que faltan siguen siendo visibles en lugar de rellenarse en silencio.
Dos cámaras, un esqueleto
El movimiento procede de vídeo de estudio grabado de frente y de lado. Un estimador de pose localiza puntos clave en cada vista; las vistas se sincronizan por el movimiento de muñecas y codos, las cámaras se calibran a partir de las propias imágenes y los puntos correspondientes se triangulan en 3D. Un hallazgo de esta etapa: con ambas cámaras fijas sobre el signante, la distancia focal no se puede recuperar solo a partir de la geometría. Añadir a la calibración un término de longitud de huesos rígidos redujo el error focal del 40–47% a no más del 1%.
Un vocabulario de movimiento
Un cuantizador vectorial residual convierte cada fotograma en 32 códigos discretos: cuatro partes del cuerpo (cuerpo, mano izquierda, mano derecha y cara), cada una refinada en ocho etapas. Separar por partes conserva distinciones que un único flujo de coordenadas difuminaría, y pasar de un solo codebook al diseño residual redujo el error de reconstrucción de unos 19° y 11 cm a unos 8° y 2 cm.
Lo que no funcionó y qué lo sustituyó
El primer plan era generar de una sola vez el movimiento de una oración completa a partir del texto. Con los instrumentos del proyecto, ningún generador de extremo a extremo se distinguió del movimiento en blanco. El enfoque actual es la composición: generar cada palabra por separado, muestrearla dieciséis veces, quedarse con la muestra que mejor lee un reconocedor y unir las palabras con una temporización predicha. El resultado sigue el orden de palabras del inglés, que no es la gramática de la ASL, y el proyecto lo dice claramente.
Leer el indicador
El movimiento generado se puntúa traduciéndolo de vuelta al inglés y comparándolo con la oración de origen, siempre junto a controles: señas reales, movimiento en blanco, orden barajado y la oración equivocada. En un conjunto nuevo de oraciones leído una sola vez, la composición obtuvo 2,40, las señas reales 4,03 y el movimiento en blanco 2,05. El hito era 2,55. No se alcanzó, y el resultado se publicó sin repetir el intento.
El lenguaje tiene que sobrevivir a todo el proceso.
- 01
Poner el movimiento en un reloj.
El vídeo frontal y lateral de How2Sign se alinea mediante el movimiento de puntos de referencia; después se calibran las cámaras, se triangulan las posiciones y se ajustan las rotaciones de las articulaciones. Las comprobaciones de reproyección y de huesos rígidos acotan la reconstrucción. Son estimaciones derivadas de vídeo, con su procedencia registrada, no datos de referencia de captura de movimiento.
- 02
Predecir códigos, no coordenadas
Un transformer autorregresivo predice los códigos residuales a partir del texto: un modelo temporal causal sobre los fotogramas, un codificador de texto a nivel de bytes y un modelo de profundidad más pequeño sobre las ocho etapas. Las primeras muestras generadas de forma libre se reconocían con mucha menos frecuencia de lo que sugerían las predicciones de un paso; el recorte, el dropout del historial y las pérdidas enmascaradas cerraron la mayor parte de esa brecha para palabras aisladas.
- 03
Pruebe lo que mide la puntuación
Un evaluador de recuperación anterior puntuaba sorprendentemente bien un movimiento con las rotaciones a cero: la duración del clip estaba filtrando la respuesta. Ventanas fijas de dos segundos, desfases aleatorios y un control basado solo en la duración permitieron poner a prueba ese atajo. La misma sospecha se aplica a cada instrumento posterior antes de permitirle calificar al generador.
El umbral de publicación se fijó antes de cualquier evaluación humana: los evaluadores sordos deben entender las oraciones generadas al menos el 70% de las veces y quedar a no más de diez puntos de las señas reales. Ese estudio está diseñado, pero no se ha realizado. Hasta que se realice, nada de lo que hay aquí respalda una afirmación de ASL comprensible.
Leer los experimentos de entrenamiento continuo.Los límites, con honestidad.
- Ningún signante sordo ha evaluado el movimiento generado. Las puntuaciones automáticas son una aproximación, no comprensión.
- El resultado sigue el orden de palabras del inglés y no modela la gramática de la ASL.
- Los pesos del modelo no se han publicado, y el sistema no es un traductor en producción.
De la observación al movimiento.
Audio en inglés. Los subtítulos están disponibles en los diez idiomas del sitio; Las traducciones son asistidas por máquina.
Leer la transcripción
00:00 Toda esa curiosidad me llevó a Sign-Translator.
00:03 Las líneas de dos cámaras se encuentran en cada articulación, lo que proporciona su posición en 3D.
00:08 La longitud constante de los huesos permitió reducir el error de la distancia focal de más del 40% a menos del 1%.
00:14 El movimiento se comprime en códigos, como un vocabulario, y un Transformer los genera a partir del inglés.
00:21 Entonces casi todo falló.
00:22 Los modelos que generaban frases completas no transmitían más significado que una figura inmóvil.
00:26 Uno pasó las 95 pruebas de movimiento, pero seguía sin poder transmitir una frase.
00:32 Así que ahora el sistema genera cada palabra por separado y une los clips.
00:37 Las palabras que no conoce simplemente desaparecen.
00:39 Para calificarlo, un modelo lee el movimiento nuevamente en inglés.
00:43 El movimiento en blanco obtiene una puntuación de 2,05, el movimiento generado 2,4 y las señas reales alrededor de 4.
00:49 Es una pequeña mejora, pero es un comienzo.
00:51 Gracias por ver el vídeo.
No se pudo iniciar la reproducción. Pruebe los controles de video o descargue el video.
Un extracto de mi portafolio de película: puntos de referencia de las manos, reconstrucción, movimiento generado y limitaciones de evaluación. El avatar renderizado y las puntuaciones automáticas demuestran el trabajo de investigación en progreso; no establecen la inteligibilidad del lenguaje de señas.
De las palabras
a movimiento.
Una pose es sólo
el comienzo.
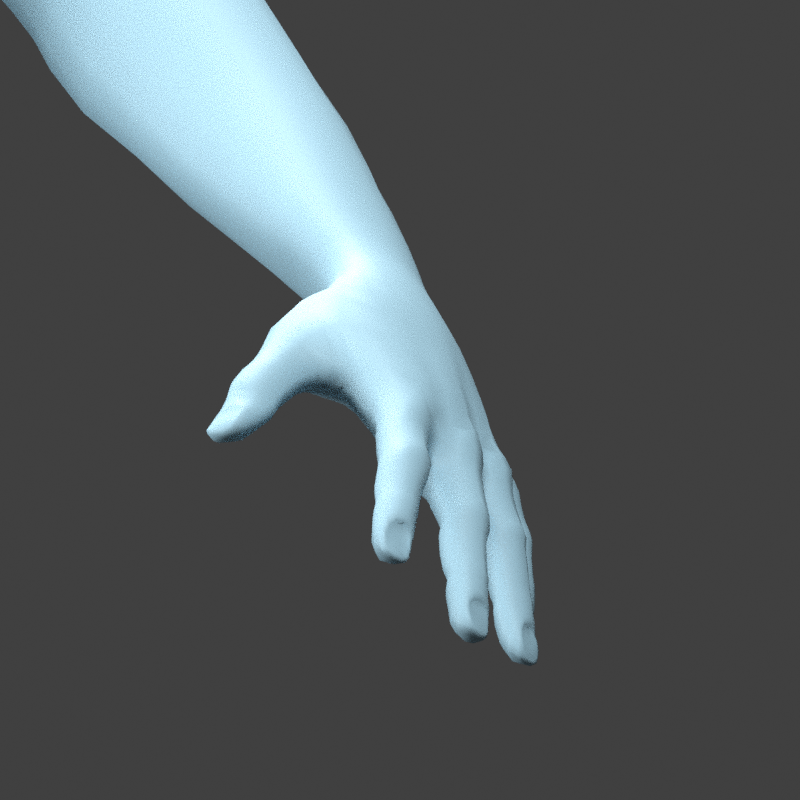
Al final, un modelo de movimiento tiene que impulsar un cuerpo. Esta representación original de articulación manual proviene de las comprobaciones de equipos del repositorio: una mirada cercana a la geometría y el comportamiento de las articulaciones detrás de un avatar.
Prueba de equipo estático. No representa una oración traducida.
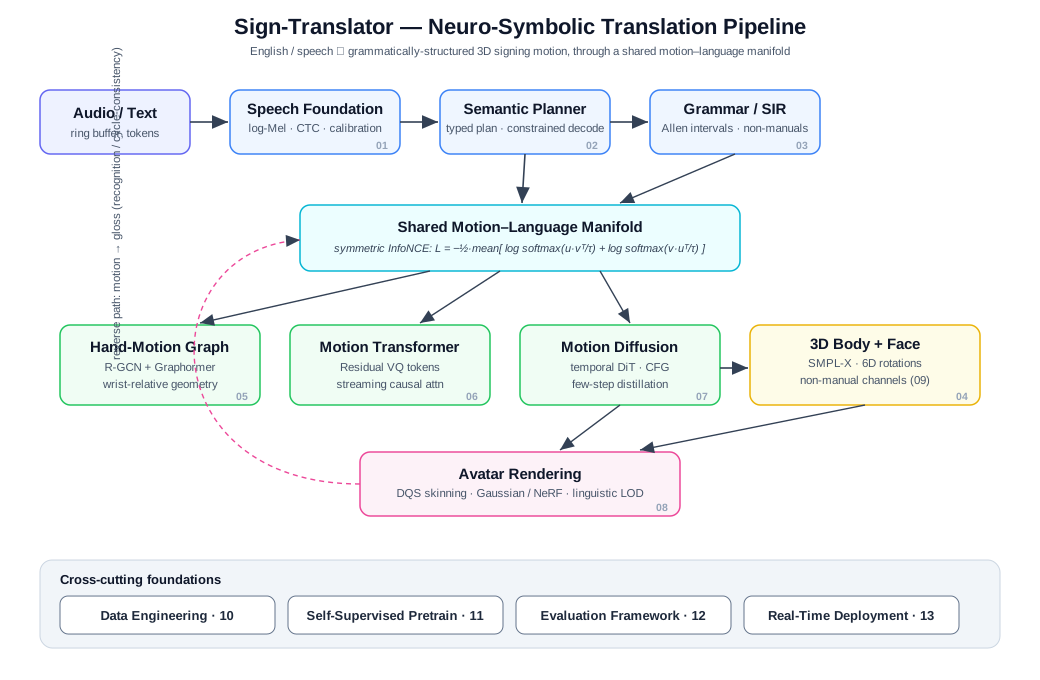
El sistema y sus límites.
El mapa de arquitectura del repositorio separa el núcleo sintético ejecutable del diseño de traducción más grande. Los experimentos de movimiento continuo más nuevos descritos anteriormente siguen un camino de entrenamiento separado.
Ver diagrama en tamaño completo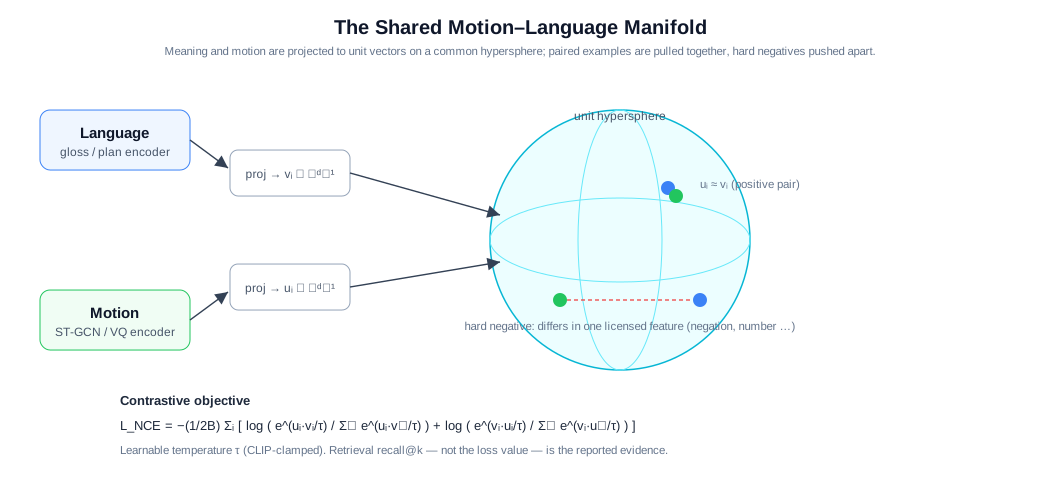
¿Pueden encontrarse el lenguaje y el movimiento?
Una red de gráficos espaciotemporales codifica el movimiento articular. Los vectores de lenguaje y movimiento están normalizados y alineados con una pérdida contrastiva simétrica: los pares coincidentes deben estar más cerca que los no coincidentes. Las pruebas de recuperación investigan esa alineación.
Ver diagrama en tamaño completoExploración adicionalCómo se diseñó la difusión condicional
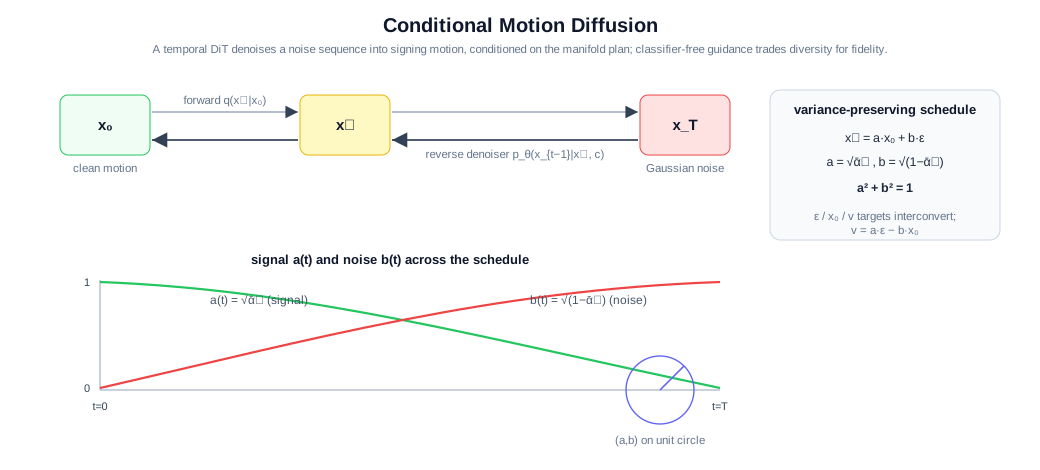
Una hipótesis generativa.
Este diagrama documenta el diseño de investigación de difusión condicional. Los experimentos continuos expusieron un modo de falla casi estático; el decodificador continuo seleccionado utiliza en cambio códigos de movimiento discretos.
Ver diagrama en tamaño completoExploración adicionalQué requiere la transmisión de movimiento
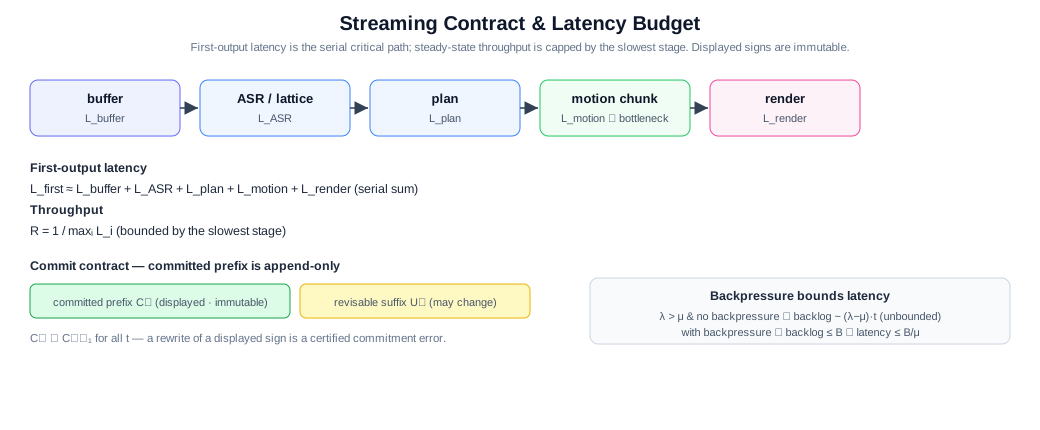
La sincronización es parte de la interfaz.
El contrato de transmisión por secuencias distingue el tiempo hasta la primera salida del rendimiento sostenido. También especifica un prefijo confirmado de solo adición para que una predicción posterior no pueda reescribir el movimiento ya mostrado. Este es un contrato de diseño, no un reclamo de latencia de producción medida.
Ver diagrama en tamaño completoDónde conecta esto.
 Encontrar el rumboAmbos controlan un cuerpo físico dentro de sus límites: allí, un timón; aquí, treinta articulaciones de los dedos.
 Evaluar mejor a un agenteLa misma desconfianza hacia los evaluadores: comprobar el instrumento antes de que puntúe nada.
 CollegeAdvisorAmbos prefieren abstenerse antes que dar una respuesta segura que la evidencia no respalda.
Prototipo de investigación en curso. Los diagramas siguientes documentan partes anteriores del diseño de investigación, y la imagen de la mano es una prueba del rig. Ni el movimiento generado ni una comprobación de renderizado demuestran que se trate de ASL lingüísticamente válida. Sigue siendo necesaria una evaluación independiente de la comprensibilidad. Vídeo de estudio: How2Sign (CC BY-NC 4.0).