Mieux évaluer un agent
Rendre les expériences logicielles plus faciles à faire confiance.
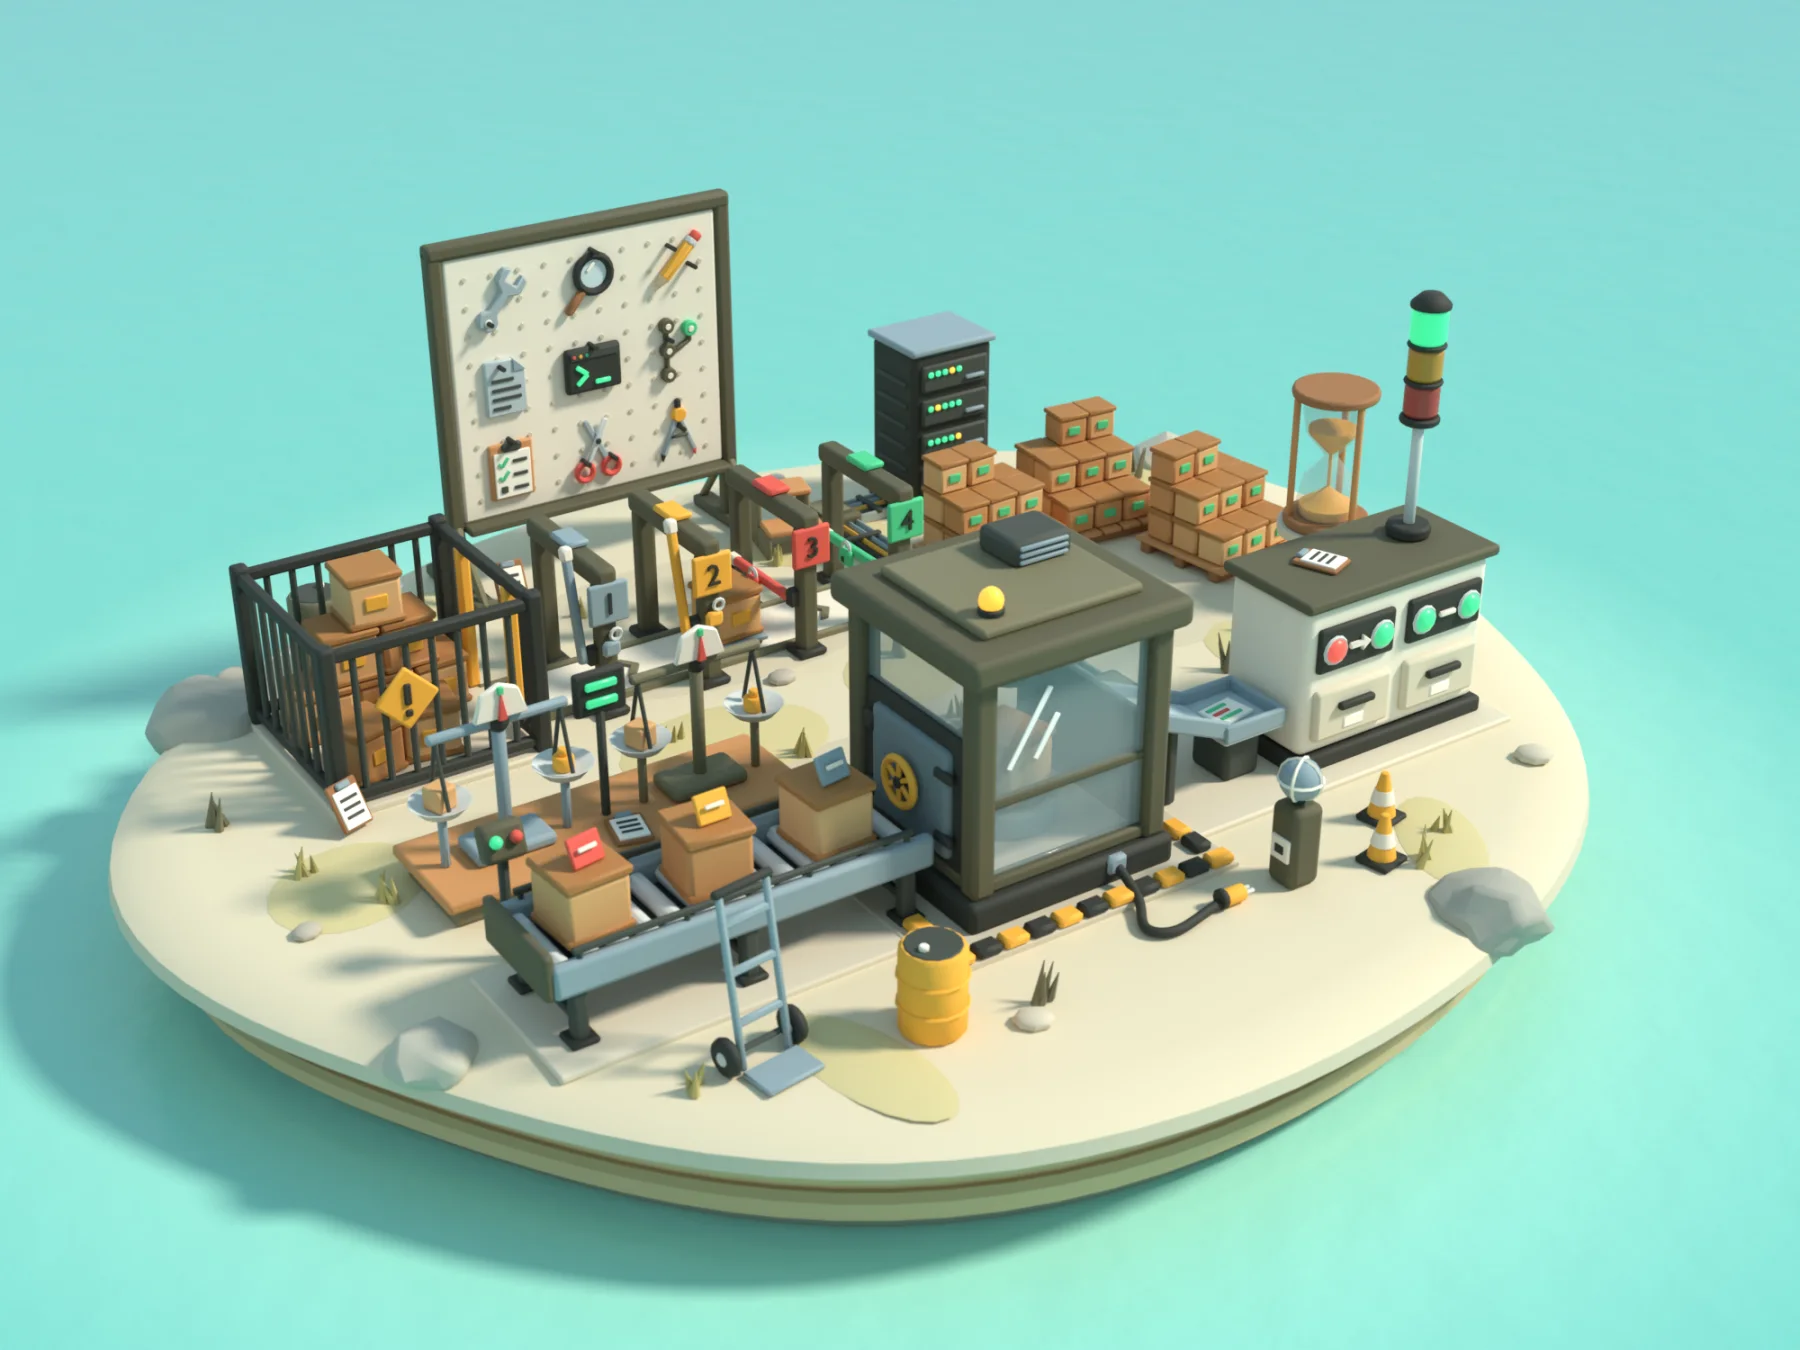
Une chaîne de tests, un enclos de quarantaine et un mur de neuf outils.
Une illustration créée pour ce site dans Blender. Elle explique l’idée ; ce ne sont pas des données du projet.
Les images, schémas et vidéos d’origine conservent leur langue originale.
Avant de se demander si un agent de codage s’est amélioré, il est utile de savoir exactement sur quoi il a été testé. Ce projet construit l’infrastructure qui sous-tend cette question pour un agent de réparation de dépôts fondé sur Gemma 4 : provenance des tâches, isolement de l’évaluation, calendriers d’entraînement déterministes et exécutions récupérables. Sa règle de travail : aucune affirmation ne doit reposer sur une étape non vérifiée.
La tâche mise à l’épreuve
L’agent reçoit un véritable dépôt open source et un problème signalé. Il peut utiliser exactement neuf outils, qui couvrent l’exécution de commandes, la lecture et la modification de fichiers, la vérification de l’état, la navigation dans la structure du code et la soumission d’un correctif. La validité du correctif est jugée par des tests que l’agent ne voit jamais.
Une salle hermétique et deux types de tests
Chaque tâche s’exécute dans un conteneur dont le réseau est coupé. Une tâche valide doit échouer avant le correctif et réussir après : les tests qui échouaient doivent désormais réussir, et ceux qui réussissaient doivent toujours réussir. Des analyseurs pour cinq frameworks de test lisent les résultats cas par cas et rejettent les récapitulatifs dont les totaux contredisent leurs propres cas.
Savoir d'où vient chaque tâche
Sur 32 079 lignes candidates, 4 818 étaient éligibles et 2 966 ont été sélectionnées puis figées en partitions d’entraînement, de développement et de confirmation, séparées par dépôt et par propriétaire afin qu’un même projet ne puisse pas apparaître des deux côtés. Les fichiers de licence ont été vérifiés au commit épinglé de chaque tâche, ce qui a permis de repérer quatre dépôts contenant un texte copyleft sous une étiquette permissive.
Quatre portes et deux vérificateurs
Les exemples d’entraînement commencent en quarantaine. Ils ne sont admis qu’après avoir franchi quatre portes : droits et attribution, isolement des partitions, qualification à l’exécution et alignement sur la tâche. Un module d’audit distinct recalcule ensuite chaque grandeur sans partager de code avec le chargeur, de sorte que les deux doivent concorder de façon indépendante. Le premier ensemble admis compte 51 tâches.
Séparer l’infrastructure des performances
Le modèle est un Gemma 4 quantifié en 4 bits avec un petit adaptateur LoRA. Jusqu’ici, il n’a reçu qu’une seule mise à jour, sur un minuscule jeu de test ; la première véritable étape d’entraînement a manqué de mémoire, a été diagnostiquée, puis corrigée dans un code qui n’a pas encore été remesuré sur GPU. Aucun entraînement prolongé n’a été lancé : le projet n’affirme donc pas que l’agent ait appris quoi que ce soit pour l’instant.
Rendre une amélioration reproductible.
- 01
Suivre la lignée de la tâche
Les tâches du référentiel comportent des contrats de provenance des sources et d'évaluation. Les contrôles de chevauchement et de quarantaine empêchent le matériel douteux d'entrer dans le parcours de formation. Cela fait de la frontière entre les données de développement et l'évaluation retenue quelque chose que les outils peuvent inspecter.
- 02
Lisez les tests, pas seulement le titre
L’audit des tests conserve le résultat de chaque cas et rejette les décomptes globaux contradictoires. Les échecs, les erreurs et les cas ignorés restent distincts. Un code de sortie indiquant la réussite ou un récapitulatif flatteur ne peuvent remplacer les preuves de test sous-jacentes.
- 03
Traduire les actions, rejouer les résultats
Les trajectoires d’un modèle enseignant issues d’un autre framework d’agents sont converties au format à neuf outils selon un ensemble fixe de règles. Les résultats des outils ne sont volontairement pas traduits : ils doivent provenir de la réexécution de l’action, car les réécrire reviendrait à fabriquer une sortie d’exécution. Un seul appel intraduisible entraîne le rejet de toute la trajectoire.
Il s’agit de mécanismes d’évaluation et de préparation de l’entraînement déjà implémentés. Le dépôt n’établit pas encore de gains appris sur des tâches de dépôts inédites, et cette page n’avance aucun résultat de compétition.
Lire le dossier de préparation à la mise en œuvreLes limites, en toute honnêteté.
- Aucun modèle n’a été entraîné à grande échelle. Il n’y a aucune amélioration mesurée à rapporter.
- Les 51 tâches admises ont toutes été exposées pendant le développement : elles ne peuvent donc pas servir de jeu de test tenu à l’écart.
- Les vérifications de licence consignent ce que chaque dépôt déclare à un commit épinglé. Ce sont des observations, et non une validation juridique.
Ce qui relie ce projet aux autres.
 ZenithSync Assay PlannerPartage son nom de projet, ZenithSync, et ses habitudes : figer le protocole, conserver les résultats négatifs.
 Le langage en mouvementLe même scepticisme envers les instruments : un vérificateur est audité avant qu’on ne lui fasse confiance.
 CollegeAdvisorChaque justificatif précise ce qu’il n’établit pas, selon la même idée que « citer ou s’abstenir ».
Outils de recherche en développement. Le projet n'a pas encore établi de gains de performances acquis sur des tâches invisibles du référentiel.