Agenten besser bewerten
Software-Experimente vertrauenswürdiger machen.
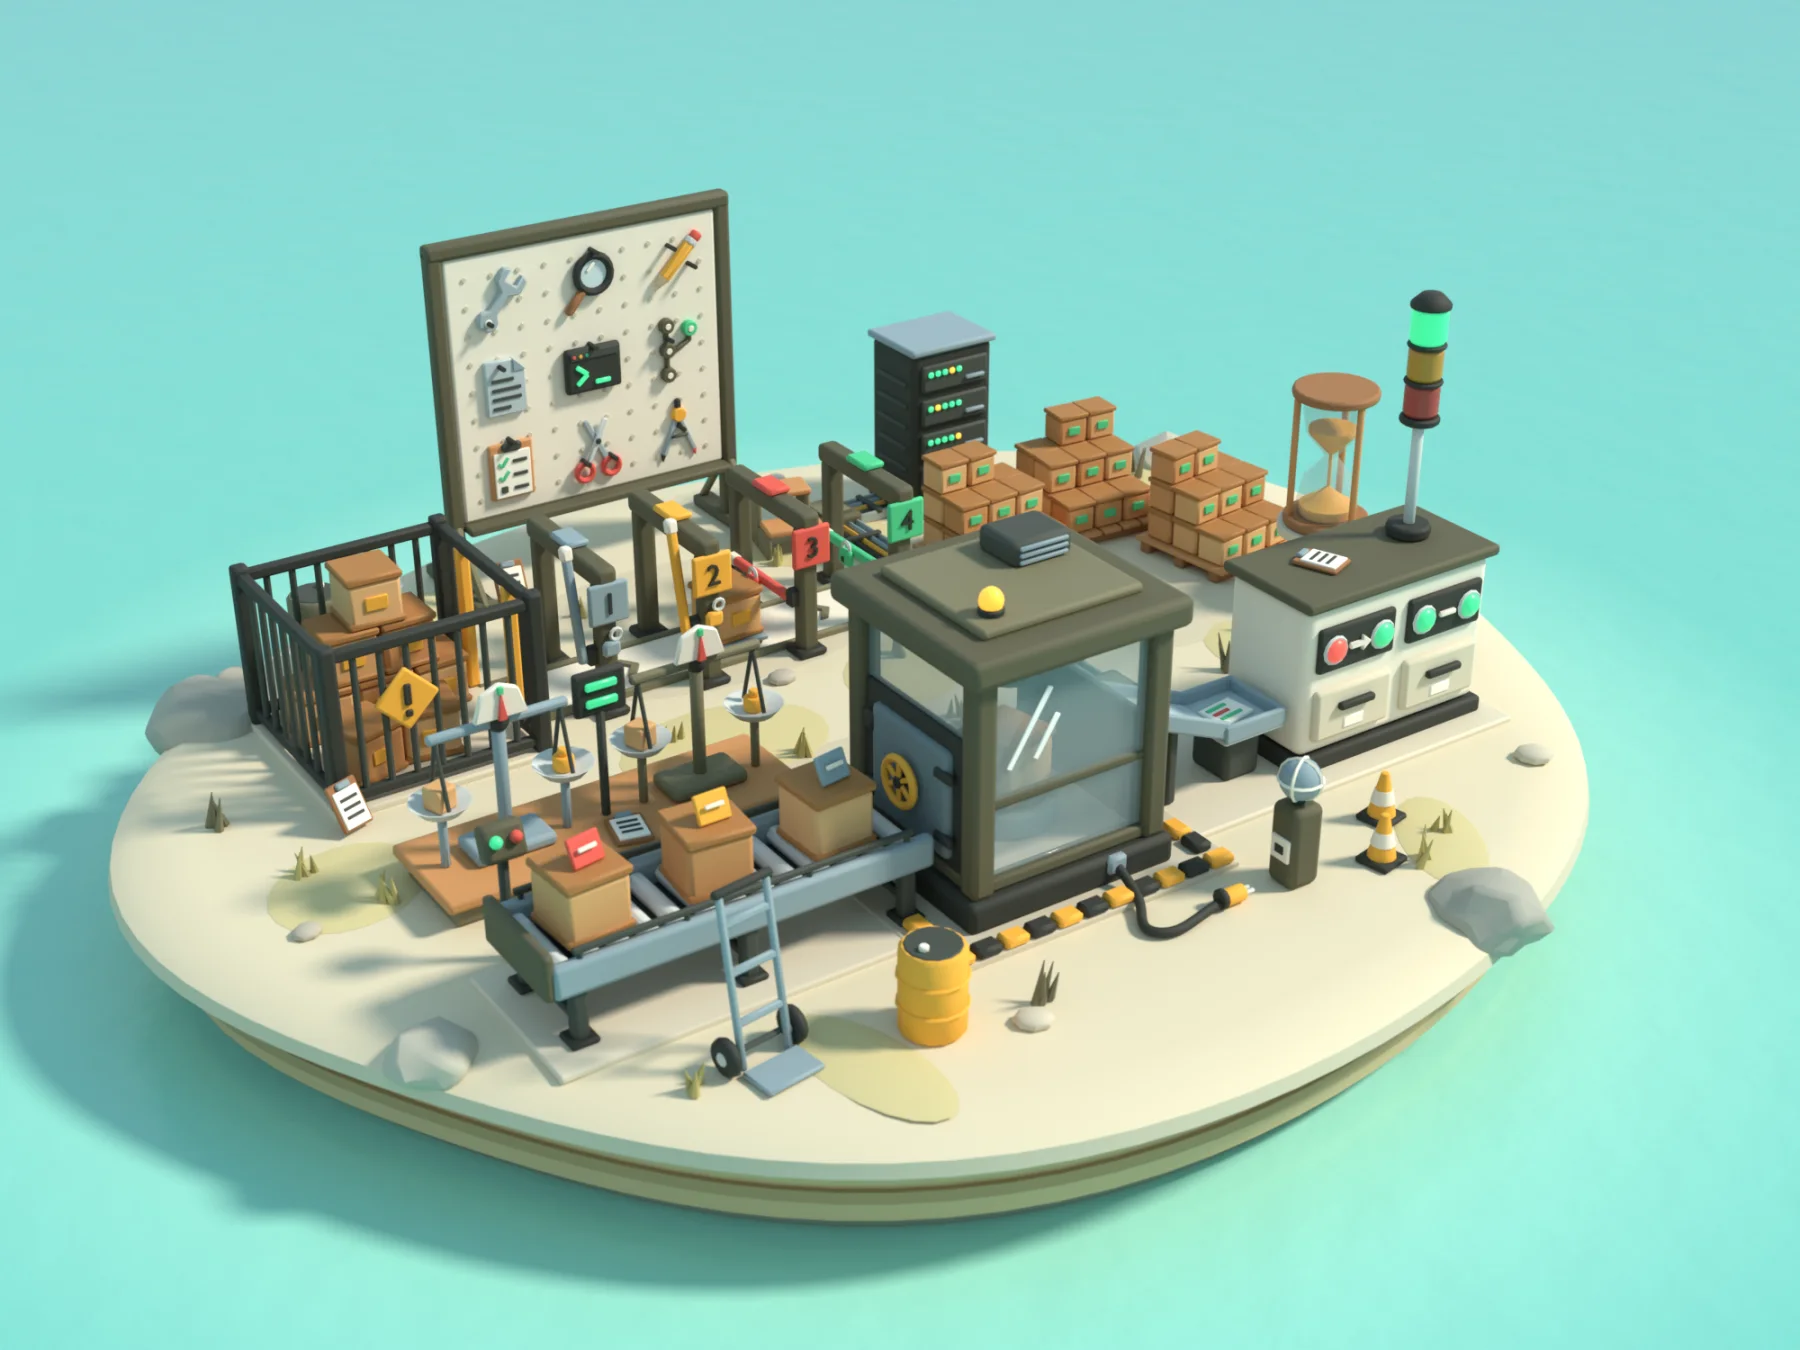
Eine Prüfstrecke, ein Quarantänepferch und eine Wand mit neun Werkzeugen.
Eine für diese Website in Blender gebaute Illustration. Sie erklärt die Idee; es sind keine Daten aus dem Projekt.
Originalbilder, Diagramme und Videos bleiben in ihrer Ausgangssprache.
Bevor man fragt, ob sich ein Coding-Agent verbessert hat, hilft es, genau zu wissen, woran er getestet wurde. Dieses Projekt baut die Infrastruktur hinter dieser Frage für einen Repository-Reparatur-Agenten auf Basis von Gemma 4: Herkunft der Aufgaben, Isolation der Evaluation, deterministische Trainingspläne und wiederaufnehmbare Läufe. Seine Arbeitsregel lautet: Keine Aussage darf auf einem ungeprüften Schritt beruhen.
Die getestete Aufgabe
Der Agent erhält ein echtes Open-Source-Repository und ein gemeldetes Issue. Er darf genau neun Werkzeuge verwenden: zum Ausführen von Befehlen, Lesen und Bearbeiten von Dateien, Prüfen des Status, Navigieren in der Codestruktur und Einreichen eines Patches. Ob der Patch korrekt ist, entscheiden Tests, die er nie zu sehen bekommt.
Ein abgeschotteter Raum und zwei Arten von Tests
Jede Aufgabe läuft in einem Container mit abgeschaltetem Netzwerk. Eine gültige Aufgabe muss vor dem Fix fehlschlagen und danach bestehen: Die Tests, die fehlschlugen, müssen nun bestehen, und die Tests, die bestanden, müssen weiterhin bestehen. Parser für fünf Test-Frameworks lesen die Ergebnisse pro Testfall und verwerfen Zusammenfassungen, deren Summen ihren eigenen Fällen widersprechen.
Wissen, woher jede Aufgabe kommt
Von 32.079 Kandidatenzeilen waren 4.818 geeignet; 2.966 wurden ausgewählt und in Trainings-, Entwicklungs- und Bestätigungs-Splits eingefroren, getrennt nach Repository und nach Eigentümer, sodass dasselbe Projekt nicht auf beiden Seiten auftauchen kann. Die Lizenzdateien wurden am festgelegten Commit jeder Aufgabe geprüft; dabei fielen vier Repositorys auf, die Copyleft-Text unter einer permissiven Kennzeichnung führten.
Vier Prüftore und zwei Prüfer
Trainingsbeispiele beginnen in Quarantäne. Zugelassen werden sie nur über vier Prüftore: Rechte und Namensnennung, Split-Isolation, Laufzeitqualifikation und Aufgabenausrichtung. Ein separates Audit-Modul berechnet anschließend jede Größe neu, ohne Code mit dem Loader zu teilen, sodass beide unabhängig voneinander übereinstimmen müssen. Der erste zugelassene Satz umfasst 51 Aufgaben.
Trennung von Infrastruktur und Leistung
Das Modell ist ein 4-Bit-Gemma-4 mit einem kleinen LoRA-Adapter. Bisher hat es ein einziges Update auf einer winzigen Test-Fixture erhalten; der erste echte Trainingsschritt lief in einen Speicherüberlauf, wurde diagnostiziert und im Code behoben, der jedoch noch nicht erneut auf einer GPU gemessen wurde. Es lief noch kein anhaltendes Training, daher behauptet das Projekt nicht, dass der Agent bereits etwas gelernt hat.
Eine Verbesserung reproduzierbar machen.
- 01
Verfolgen Sie die Abstammung der Aufgabe
Repository-Aufgaben beinhalten Quellenherkunfts- und Bewertungsverträge. Überschneidungsprüfungen und Quarantäne verhindern, dass fragwürdiges Material in den Schulungspfad gelangt. Dadurch wird die Grenze zwischen Entwicklungsdaten und aufgeschobener Auswertung zu etwas, das von den Werkzeugen überprüft werden kann.
- 02
Lesen Sie die Tests, nicht nur die Überschrift
Die Testprüfung bewahrt die Ergebnisse einzelner Testfälle und verwirft widersprüchliche Gesamtzahlen. Fehlschläge, Fehler und übersprungene Fälle bleiben unterscheidbar. Ein erfolgreicher Prozess-Exit oder eine ansprechende Zusammenfassung kann die zugrunde liegenden Testbelege nicht ersetzen.
- 03
Aktionen übersetzen, Ergebnisse neu abspielen
Lehrer-Trajektorien aus einem anderen Agenten-Framework werden nach einem festen Regelwerk in das Neun-Werkzeuge-Format überführt. Werkzeugergebnisse werden bewusst nicht übersetzt: Sie müssen aus dem erneuten Ausführen der Aktion stammen, denn sie umzuschreiben hieße, Laufzeitausgaben zu fälschen. Ein einziger nicht übersetzbarer Aufruf verwirft die gesamte Trajektorie.
Dies sind implementierte Mechanismen für Evaluation und Trainingsvorbereitung. Das Repository belegt noch keine gelernten Verbesserungen bei unbekannten Repository-Aufgaben, und diese Seite erhebt keinen Anspruch auf ein Wettbewerbsergebnis.
Lesen Sie den ImplementierungsbereitschaftsdatensatzDie ehrlichen Grenzen.
- Es wurde kein Modell in großem Maßstab trainiert. Es gibt keine gemessene Verbesserung zu berichten.
- Alle 51 zugelassenen Aufgaben waren in der Entwicklung bereits sichtbar und können daher nicht als zurückgehaltener Test dienen.
- Lizenzprüfungen halten fest, was jedes Repository an einem festgelegten Commit angibt. Sie sind Beobachtungen, keine rechtliche Freigabe.
Wo sich das verbindet.
 ZenithSync Assay PlannerTeilt den Projektnamen ZenithSync und die Gewohnheiten: das Protokoll einfrieren, die negativen Ergebnisse behalten.
 Sprache in BewegungSkepsis gegenüber Messinstrumenten in beiden: Ein Verifizierer wird geprüft, bevor man ihm glaubt.
 CollegeAdvisorJedes Protokoll hält fest, was es nicht belegt – dieselbe Idee wie „Quelle oder Verzicht“.
Forschungswerkzeuge in der Entwicklung. Das Projekt ermittelt noch keine erlernten Leistungssteigerungen bei unbekannten Repository-Aufgaben.