ZenithSync Assay Planner
Que devrait mesurer ensuite une expérience ?
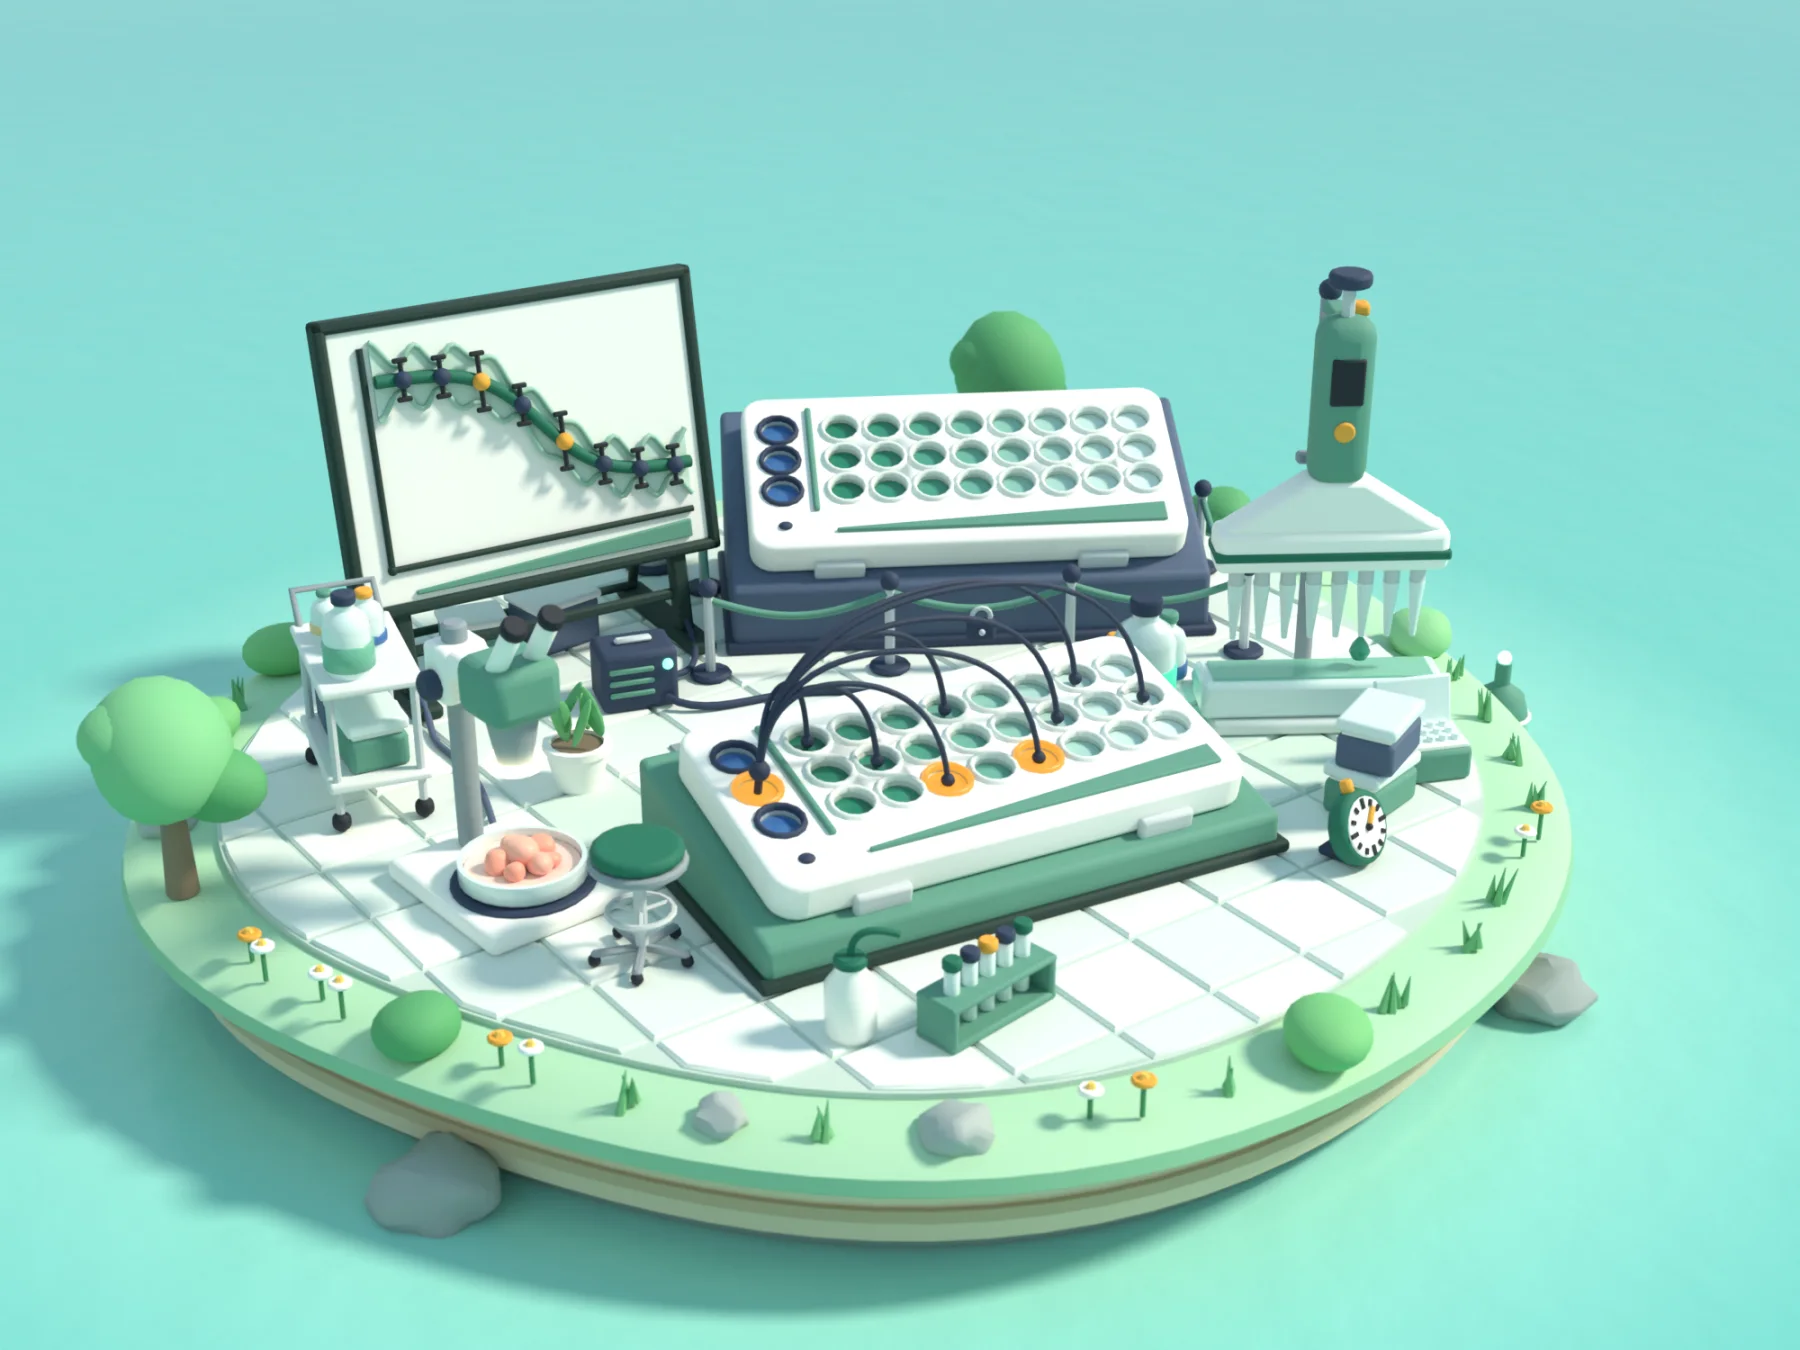
Deux plaques, une courbe et trois puits qui valent l’achat.
Une illustration créée pour ce site dans Blender. Elle explique l’idée ; ce ne sont pas des données du projet.
Les images, schémas et vidéos d’origine conservent leur langue originale.
Chaque mesure consomme une partie du budget d’une expérience. Étant donné un témoin et les doses la plus faible et la plus élevée déjà mesurées, quels puits un laboratoire devrait-il acheter ensuite pour cerner la courbe dose-réponse d’un médicament ? J’ai construit un planificateur qui tient compte de ce qui est déjà connu, des zones où l’incertitude demeure et de la façon dont un témoin partagé influe sur plusieurs mesures de traitement à la fois.
Le problème du contrôle partagé
La réponse à un traitement se lit par rapport à un témoin mesuré. Lorsque plusieurs réponses partagent cette référence, leurs erreurs sont liées : si la mesure du témoin est trop haute, tous les contrastes sont trop bas à la fois. Le planificateur conserve cette dépendance au lieu de considérer le témoin comme parfaitement connu, et peut choisir d’acheter un puits témoin supplémentaire lorsque cela aide davantage qu’un puits traité de plus.
Une courbe qui part de zéro
La réponse est modélisée par un processus gaussien sur le logarithme de la dose, avec un noyau ajusté pour que l’effet du médicament à dose nulle soit exactement zéro. Un témoin ne porte donc aucun effet du médicament, mais porte tout de même de l’information, via le bruit partagé. Les hyperparamètres ont été choisis une seule fois par validation croisée en laissant un organoïde de côté sur un jeu de développement, où les 28 plis ont retenu le même réglage, puis figés.
Choisir un lot de façon exacte
Pour un budget fixé, le planificateur examine tous les ensembles de puits possibles et retient celui qui laisse la plus faible incertitude moyenne sur les doses prévues. Les puits interchangeables sont regroupés, de sorte qu’un seul représentant tient lieu de nombreux ensembles équivalents : 13 408 représentants couvraient 2 113 536 sous-ensembles lors de la confirmation. Un petit contre-exemple dans les tests montre pourquoi c’est important : le meilleur puits isolé ne fait pas toujours partie de la meilleure paire.
Mettre l’affirmation à l’épreuve sur des données inédites
Le protocole a été figé et horodaté avant l’ouverture des réponses du jeu de confirmation. Ce jeu comporte deux plaques parallèles par contexte : les puits sont choisis sur l’une et jugés sur l’autre. Sur 6 496 contextes issus de 148 échantillons d’organoïdes et de 100 patients, la sélection exacte a réduit l’erreur quadratique moyenne de 32,82 % par rapport à une sélection aléatoire avec le même modèle. Face à la référence gloutonne, plus solide, l’amélioration était de 0,66 % : c’est la taille honnête de l’avantage de la recherche exacte.
Ce qui est resté consigné
Sur le jeu de développement, la même comparaison n’a pas été concluante : chaque intervalle bootstrap incluait zéro. Un pilote antérieur sur puce hépatique n’a pas non plus donné de résultat positif. Tous deux restent dans le dépôt à côté de la confirmation, de même qu’une première exécution de l’évaluateur qui avait planté, conservée et modifiée uniquement pour la sérialisation.
Le puits de contrôle fait partie du modèle.
- 01
Conserver la covariance
Soustraire le même témoin mesuré de plusieurs mesures de traitement introduit une erreur partagée. Avec des erreurs brutes indépendantes de variance s², la covariance du bruit des contrastes est R = s²(I + 11ᵀ) : 2s² sur la diagonale et s² en dehors. Le modèle gaussien conjoint préserve cette dépendance ; son erreur était inférieure de 11,36 % à celle d’une ablation qui l’ignore.
- 02
Rechercher dans l'espace de conception fini
L’optimiseur choisit un lot à budget fixe en minimisant la variance a posteriori, pondérée de manière égale, aux doses prévues : C − C[:,A] C[A,A]⁻¹ C[A,:]. Les puits dont l’interchangeabilité a été vérifiée sont regroupés, de sorte qu’un seul représentant par profil d’effectifs est évalué. Cela réduit l’énumération sans changer l’optimum du problème borné, ce que les tests vérifient par comparaison avec une recherche exhaustive.
- 03
Geler, puis évaluer
Les choix de modèle ont été figés avant la confirmation sur une étude publique distincte portant sur des organoïdes. Les stratégies exacte, gloutonne et aléatoire partagent le même modèle de prédiction et le même budget de mesures. L’inférence rééchantillonne des patients entiers après avoir moyenné les contextes au sein des échantillons et les échantillons au sein des patients, de sorte que des contextes répétés ne sont pas comptés comme des preuves indépendantes.
L’objectif de covariance dépend du plan d’expérience et de l’emplacement des puits observés, et non des valeurs de réponse. Il s’agit d’un plan par lots à modèle fixe ; les prédictions se mettent à jour avec les mesures, mais la règle de sélection ne s’adapte pas aux réponses. Le critère d’évaluation est l’erreur sur le signal brut log(traitement) moins témoin, et non la viabilité.
Lire l'audit mathématique et contributifLes limites, en toute honnêteté.
- Il s’agit de résultats rétrospectifs sur des données publiques. Des économies dans un vrai laboratoire n’ont pas été démontrées.
- Les intervalles nominaux à 90 % couvraient 98,05 % des mesures tenues à l’écart : ils sont donc prudents plutôt que bien calibrés.
- Aucun bénéfice clinique, aucune relecture par les pairs ni aucun classement en concours n’est revendiqué. J’étais le seul membre de l’équipe et le seul relecteur.
A y regarder de plus près.
Procédure pas à pas du projet original avec narration synthétique. Enregistré pendant la phase de révision. Lire la transcription ↗
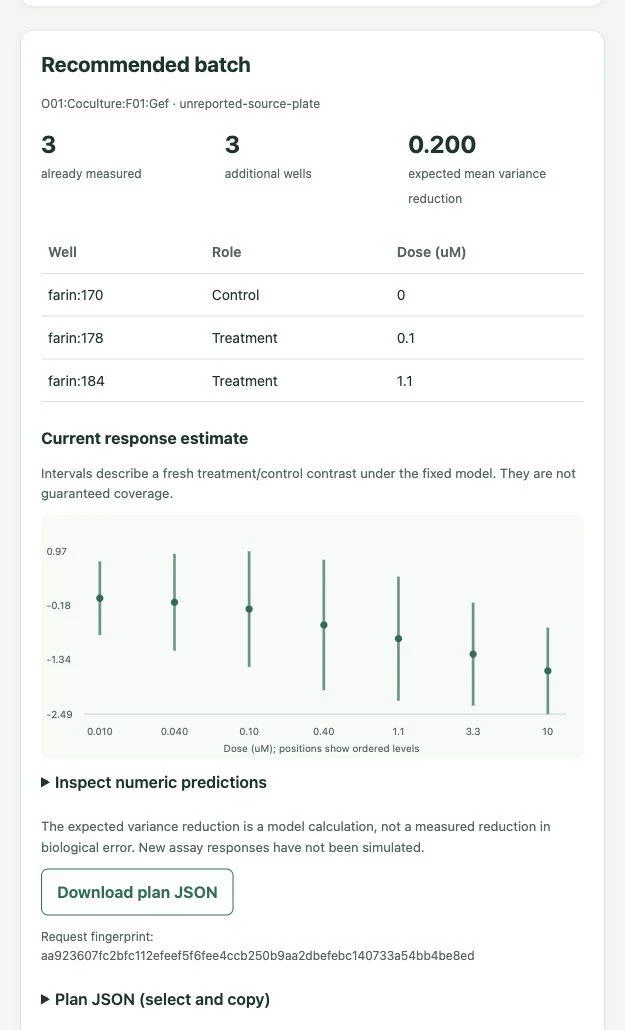
Un plan que vous pouvez inspecter.
L'interface locale répertorie les puits sélectionnés, leurs rôles et les estimations de réponse du modèle. Le résultat peut être téléchargé pour une inspection plus approfondie.
Capture d'écran du projet provenant du référentiel de recherche public.
Ce qui relie ce projet aux autres.
 Mieux évaluer un agentLes deux figent le protocole avant de regarder, et les deux conservent les résultats peu flatteurs.
 Au-delà de la carte thermiqueL’incertitude comme guide pour savoir où affecter des ressources limitées.
 La science, clairementLes sciences de la vie reviennent, cette fois sous la forme d’un problème de statistique plutôt que de paillasse.
Il s’agit de résultats de recherche rétrospectifs. Des économies prospectives en laboratoire, un bénéfice clinique et le transfert à des expériences d’organes sur puce perfusés n’ont pas été démontrés. Données de développement : Farin et al. ; données de confirmation : Kryeziu et al. ; toutes deux publiques.