ZenithSync Assay Planner
接下來實驗該測量什麼?
兩塊孔盤、一條曲線,以及三個值得買的孔。
為本網站以 Blender 製作的插圖。它用來說明概念,並非專案的資料。
專案原始圖片、圖表和影片保留原文。
每次量測都會用掉實驗預算的一部分。已有一個對照組,也已測得最低與最高劑量,實驗室接下來該購買哪幾個孔,才能確定藥物的劑量反應曲線?我建立了一個規劃器,它會考量哪些已經知道、哪裡仍有不確定性,以及共用的對照組如何同時影響多個處理組量測。
共享控制問題
處理組的反應是相對於一個實測的對照組來解讀的。當多個反應共用這個參照時,它們的誤差就會彼此相關:若對照組讀數偏高,所有對比值就會一起偏低。規劃器保留這種相依性,而不是把對照組當成完全已知;當多測一個對照孔比多測一個處理孔更有幫助時,它也可以選擇購買對照孔。
從零出發的曲線
反應以對數劑量上的高斯過程建模,並調整核函數,使藥物在零劑量時的效果恰好為零。因此,對照組不帶有藥物效果,但仍透過共同雜訊攜帶資訊。超參數只在開發資料集上以「留一類器官」驗證選定一次(全部 28 折都選出相同設定),之後即凍結。
精確選出一批孔
在固定預算下,規劃器搜尋所有可能的孔組合,保留在規劃劑量上平均不確定性最低的那一組。可互換的孔會被歸為一組,由一個代表涵蓋許多等價的組合:在確認階段,13,408 個代表涵蓋了 2,113,536 個子集。測試中有一個小型反例說明了為什麼這很重要:單獨最好的一個孔,不一定屬於最好的一對。
在模型沒看過的資料上檢驗主張
在打開確認資料集的反應數據之前,實驗規程就已凍結並加上時間戳記。該資料集每個情境有兩塊平行孔盤:從其中一塊選孔,再用另一塊來評判。在來自 100 位病患、148 個類器官樣本的 6,496 個情境中,在相同模型下,精確選擇比隨機選擇的均方誤差低 32.82%。相對於較強的貪婪基準,改善幅度為 0.66%,這才是精確搜尋優勢的真實大小。
留在紀錄中的事
在開發資料集上,同樣的比較沒有定論:每個拔靴法區間都包含零。較早的一項肝臟晶片先導研究也沒有得到正面結果。兩者都與確認結果一起保留在儲存庫中,還有第一次評估器執行時當機的紀錄,它被保留下來,僅針對序列化問題進行修正。
控制井是模型的一部份。
- 01
維持協方差
從多個處理組讀數中減去同一個實測對照值,會引入共同誤差。若原始誤差彼此獨立、變異數為 s²,對比雜訊的共變異數為 R = s²(I + 11ᵀ):對角線上為 2s²,對角線外為 s²。聯合高斯模型保留了這種相依性;其誤差比忽略此相依性的消融版本低 11.36%。
- 02
搜尋有限設計空間
最佳化器在固定預算下選擇一批孔,方法是最小化設計劑量上等權重的後驗變異數,C − C[:,A] C[A,A]⁻¹ C[A,:]。經驗證可互換的孔會被歸為一組,每種計數模式只評估一個代表。這在不改變有界問題最佳解的前提下減少了枚舉量,並在測試中與暴力搜尋結果相互核對。
- 03
凍結,然後評估
模型選擇在一份獨立的公開類器官研究上進行確認之前就已固定。精確、貪婪與隨機三種策略共用相同的預測模型與量測預算。推論時先在樣本內平均各情境、在病患內平均各樣本,再以整位病患為單位重新抽樣,因此重複的情境不會被當作獨立證據。
共變異數目標函數取決於設計與已觀測孔的位置,而不是反應值。這是固定模型的批次設計:預測會隨量測更新,但選擇規則不會隨反應自適應調整。終點指標是原始對數「處理組減對照組」訊號的誤差,而非細胞存活率。
閱讀數學與貢獻審計誠實的邊界。
- 這些是基於公開資料的回溯性結果。在真實實驗室中的節省效果尚未得到證實。
- 名義上 90% 的區間涵蓋了 98.05% 的保留讀數,因此這些區間偏保守,而非校準良好。
- 本專案不主張任何臨床效益、同儕審查或競賽名次。我是唯一的團隊成員,也是唯一的審查者。
仔細觀察。
具有合成敘述的原始項目演練。審核階段記錄。 閱讀文字記錄↗
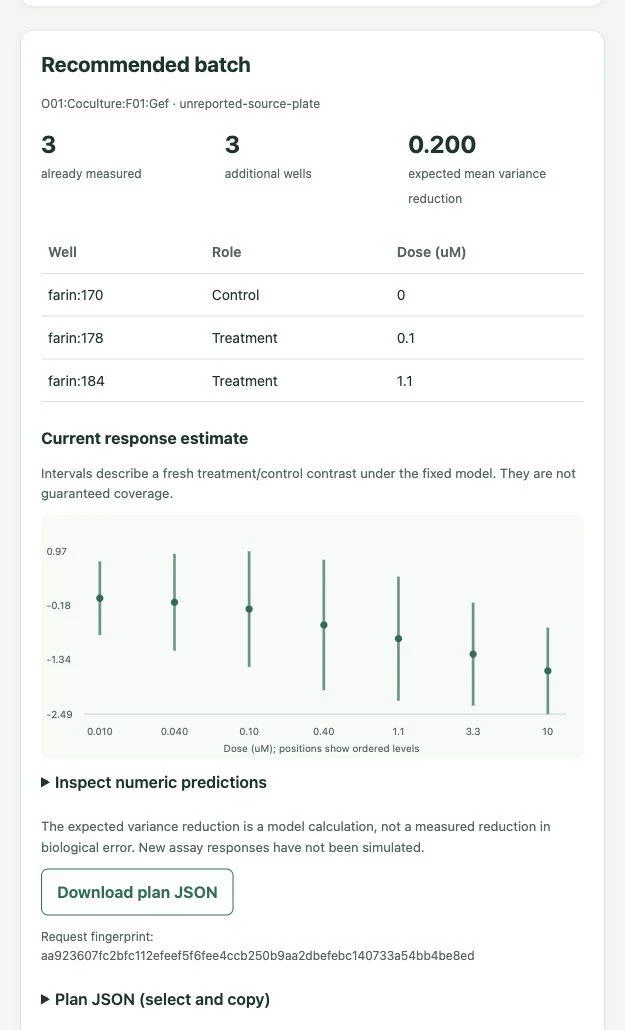
您可以檢查的計劃。
本地介面列出了選定的井、它們的角色以及模型的反應估計。可以下載結果以進行進一步檢查。
來自公共研究儲存庫的專案螢幕截圖。