ZenithSync Assay Planner
실험에서는 다음으로 무엇을 측정해야 합니까?
플레이트 둘, 곡선 하나, 그리고 살 가치가 있는 웰 셋.
이 사이트를 위해 Blender로 만든 일러스트입니다. 개념을 설명할 뿐, 프로젝트의 데이터가 아닙니다.
프로젝트의 원본 이미지, 도표, 영상은 원래 언어로 제공됩니다.
모든 측정은 실험 예산의 일부를 씁니다. 대조군 하나와 이미 측정한 최저·최고 용량이 주어졌을 때, 약물의 용량-반응 곡선을 확정하려면 실험실은 다음으로 어떤 웰 몇 개를 사야 할까요? 저는 이미 알려진 것, 불확실성이 남아 있는 곳, 그리고 공유된 대조군이 여러 처리군 측정에 동시에 어떤 영향을 주는지를 고려하는 플래너를 만들었습니다.
공유 제어 문제
처리군의 반응은 측정된 대조군을 기준으로 읽습니다. 여러 반응이 같은 기준을 공유하면 그 오차들은 서로 연관됩니다. 대조군 값이 높게 읽히면 모든 대비가 함께 낮게 읽힙니다. 이 플래너는 대조군을 완벽히 알려진 값으로 취급하지 않고 이 의존성을 유지하며, 처리군 웰을 하나 더 사는 것보다 도움이 될 때는 대조군 웰을 하나 더 사는 쪽을 선택할 수 있습니다.
0에서 시작하는 곡선
반응은 로그 용량에 대한 가우스 프로세스로 모델링하며, 커널을 조정해 용량이 0일 때 약물 효과가 정확히 0이 되도록 했습니다. 따라서 대조군에는 약물 효과가 없지만, 공유된 잡음을 통해 여전히 정보를 담고 있습니다. 하이퍼파라미터는 개발 데이터셋에서 오가노이드 하나씩 빼는(leave-one-organoid-out) 검증으로 한 번 선택했는데, 28개 폴드 모두 같은 설정을 골랐고, 그 뒤 고정했습니다.
배치를 정확하게 고르기
주어진 예산에 대해 플래너는 가능한 모든 웰 조합을 탐색하고, 계획된 용량 전반에서 평균 불확실성을 가장 작게 남기는 조합을 고릅니다. 서로 바꿔도 같은 웰은 묶어서, 대표 하나가 동등한 여러 조합을 대신하게 합니다. 확인 단계에서는 대표 13,408개가 부분집합 2,113,536개를 포괄했습니다. 테스트에 포함된 작은 반례가 이것이 왜 중요한지 보여 줍니다. 가장 좋은 단일 웰이 항상 가장 좋은 쌍에 포함되는 것은 아닙니다.
처음 보는 데이터로 주장을 검증하기
확인용 데이터셋의 반응 값을 열어 보기 전에 프로토콜을 동결하고 타임스탬프를 남겼습니다. 이 데이터셋에는 맥락마다 평행 플레이트가 두 개 있어서, 한쪽에서 웰을 고르고 다른 쪽으로 평가합니다. 오가노이드 샘플 148개와 환자 100명에서 나온 6,496개 맥락에 걸쳐, 정확 선택은 같은 모델에서 무작위 선택보다 평균 제곱 오차를 32.82% 줄였습니다. 더 강력한 탐욕 기준선과 비교한 개선은 0.66%였으며, 이것이 정확 탐색이 가진 이점의 정직한 크기입니다.
기록에 남은 것
개발 데이터셋에서는 같은 비교가 결론을 내지 못했습니다. 모든 부트스트랩 구간이 0을 포함했습니다. 앞서 진행한 간 칩(liver-chip) 파일럿에서도 긍정적인 결과는 나오지 않았습니다. 두 결과 모두 확인 결과와 함께 저장소에 남아 있으며, 중단된 첫 평가기 실행 기록도 보존되어 있습니다. 이 기록은 직렬화 부분만 수정했습니다.
제어 우물은 모델의 일부입니다.
- 01
공분산 유지
같은 대조군 측정값을 여러 처리군 측정값에서 빼면 공유 오차가 생깁니다. 원시 오차가 서로 독립이고 분산이 s²일 때, 대비 잡음의 공분산은 R = s²(I + 11ᵀ)로, 대각 성분은 2s², 비대각 성분은 s²입니다. 결합 가우스 모델은 이 의존성을 보존하며, 이를 무시한 절제(ablation) 모델보다 오차가 11.36% 낮았습니다.
- 02
유한한 설계 공간 검색
최적화기는 설계된 용량에서의 동일 가중 사후 분산 C − C[:,A] C[A,A]⁻¹ C[A,:]를 최소화하여 고정 예산 배치를 선택합니다. 교환 가능성이 검증된 웰은 묶어서, 개수 패턴마다 대표 하나만 평가합니다. 이렇게 하면 유계 문제의 최적해를 바꾸지 않고 열거량을 줄일 수 있으며, 테스트에서 전수 탐색과 대조해 확인합니다.
- 03
동결한 후 평가
모델 선택은 별도의 공개 오가노이드 연구로 확인하기 전에 고정했습니다. 정확(exact), 탐욕(greedy), 무작위 정책은 같은 예측 모델과 측정 예산을 공유합니다. 추론에서는 샘플 내 맥락과 환자 내 샘플을 평균한 뒤 환자 단위로 재표본추출하므로, 반복된 맥락이 독립적인 증거로 계산되지 않습니다.
공분산 목적함수는 반응 값이 아니라 설계와 관측된 웰의 위치에 따라 달라집니다. 이는 고정 모델 배치 설계로, 예측은 측정값에 따라 갱신되지만 선택 규칙은 반응에 따라 적응하지 않습니다. 평가 지표는 생존율이 아니라 처리군에서 대조군을 뺀 원시 로그 신호의 오차입니다.
수학 및 기여 감사 읽기정직하게 밝히는 한계.
- 공개 데이터에 대한 후향적 결과입니다. 실제 실험실에서의 비용 절감은 입증되지 않았습니다.
- 명목상 90% 구간이 따로 남겨 둔 측정값의 98.05%를 포함했으므로, 이 구간은 잘 보정되었다기보다는 보수적입니다.
- 임상적 이점, 동료 심사, 대회 입상을 주장하지 않습니다. 팀원도 저 혼자였고, 검토자도 저 혼자였습니다.
자세히 살펴보세요.
합성 내레이션이 포함된 오리지널 프로젝트 연습입니다. 검토 단계에서 녹음되었습니다. 대본 읽기 ↗
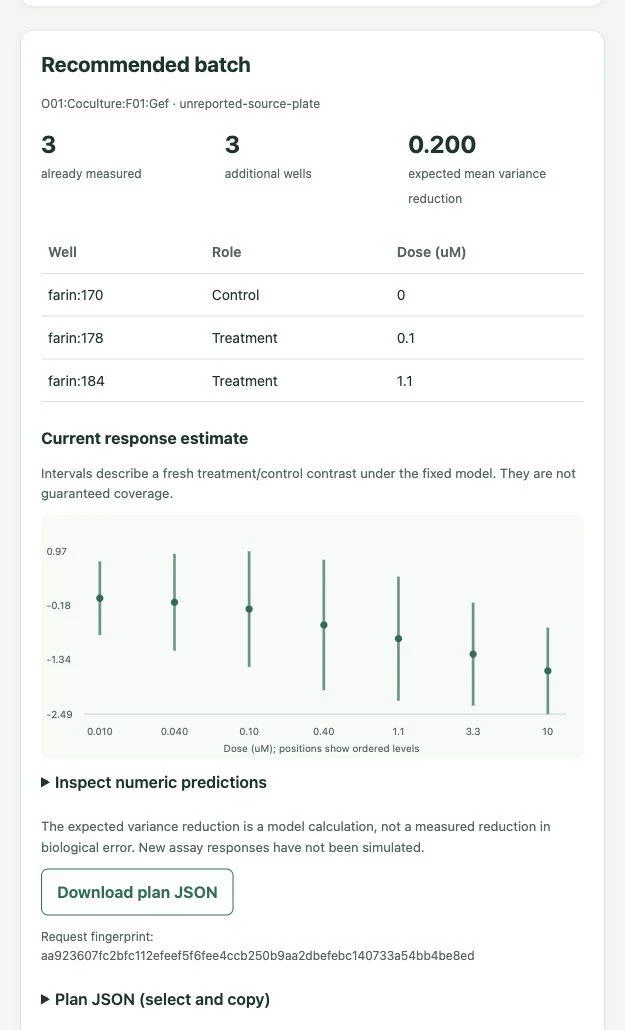
점검할 수 있는 계획입니다.
로컬 인터페이스에는 선택된 우물, 해당 역할 및 모델의 반응 추정치가 나열됩니다. 추가 검사를 위해 결과를 다운로드할 수 있습니다.
공공 연구 저장소의 프로젝트 스크린샷.
이어지는 지점.
이는 기존 데이터를 이용한 후향적 연구 결과입니다. 전향적인 실험실 비용 절감, 임상적 이점, 관류형 장기 칩 실험으로의 적용은 입증되지 않았습니다. 개발 데이터: Farin et al.; 확인 데이터: Kryeziu et al.; 모두 공개 데이터입니다.